导语:OpenAI与Anthropic同日更新旗舰模型,行业讨论焦点落在“大家怎么都变便宜了”。但细看价格表就会发现,OpenAI所谓腰斩,更像是把中端型号Terra从梯队里抹掉、整体上移一格后的定价叙事;真正的降本成色,要看各家架构与缓存策略的差别。
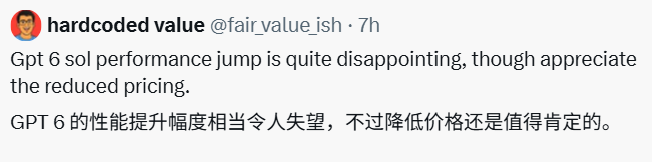
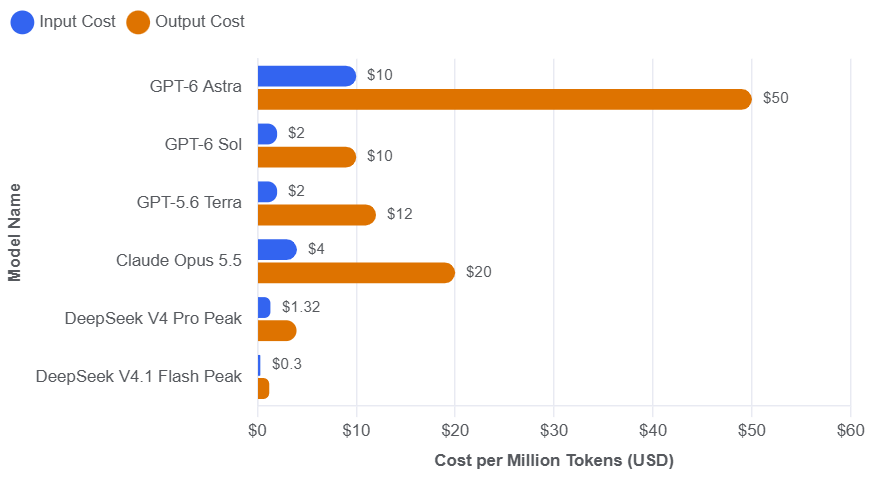
今早硅谷再度热闹起来,双雄同日对决:Anthropic推出Claude Opus 5.5,OpenAI紧接着推出GPT-6 Sol与Luna。和以往模型更新不同的是,行业的讨论点聚焦到了“大家怎么都变便宜了”。Claude Opus 5.5较上一代Opus 5成本降低40%,拥有Fable级性能;GPT-6 Sol降得更狠——性能持平GPT-5.6 Sol,价格直接腰斩,每百万Token输入2美元、输出10美元,性价比看似要一步踩进DeepSeek的腹地。
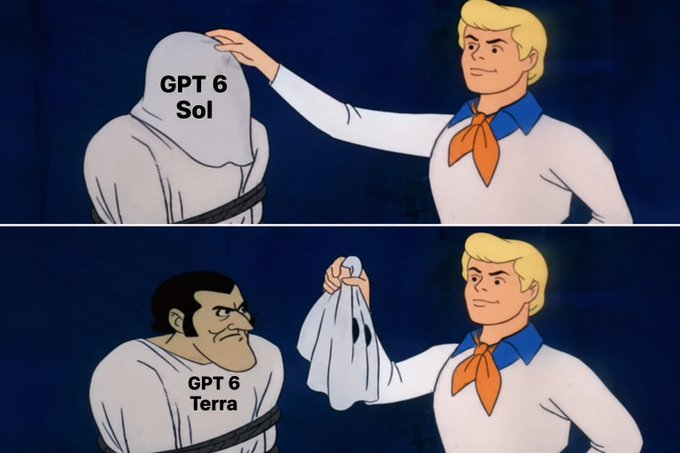
但如果仔细对照,就会发现OpenAI所谓腰斩,是抹掉了一个型号Terra。OpenAI之前的模型档位是:旗舰Sol、中端Terra、轻量Luna;现在变成了Astra、Sol、Luna。Terra哪去了?网友戏称变成Sol了,把整个梯队往上提了一格。再重新对比一下GPT-5.6 Terra——每百万Token输入2美元、输出12美元,和GPT-6 Sol对照看几乎没什么变化。这波降价潮的真相,也就不言自明了。
01 降价潮的成色各不相同
当下AI赛道价格战白热化,各大厂商纷纷下调模型定价,但降价的成色、逻辑和含金量天差地别。Anthropic降价最有诚意,DeepSeek仍有绝对成本优势(但差距在缩小),OpenAI更像是商业定价叙事为主、工程优化为辅的策略型降价。
先说Anthropic。它走的是“强模型,真降价”路线:Claude Fable 5.1本来定位就是模型天花板,专攻高价值复杂推理场景;Claude Opus 5.5在大多数日常任务中性能与之相当,仅在极深度逻辑推导、超大规模代码工程等高难度场景存在差距——相当于用40%价格保留80%核心能力。Opus 5.5真正厉害之处,在于解决了长任务里最烧钱的隐形开销——思维链。在大厂的不少工作场景中,处理长文档分析、多轮工具调用等任务会让模型在自我纠错和深度推导中烧掉预算;Opus 5.5不只把基础价格降了,更将核心的“缓存读取”费用降了60%。这样一来,长任务里“深度思考”的总成本少了近六成,开发者敢频繁调用高阶推理了。
而DeepSeek的绝对成本优势仍在,闲时还能减半。如果把DeepSeek与OpenAI的中端模型对比,可以看出OpenAI已经在努力向DeepSeek靠拢。再看轻量级战场,不少人会困惑:似乎账面上OpenAI更便宜——单看高峰时段标价,DeepSeek-V4.1-Flash的输入费是GPT-6 Luna的1.5到3倍,输出费是1.2到2.4倍。不过这两者在性能和体量上不能放一起比较。GPT-6 Luna是一个真正意义上的“小模型”,体积可能只有十几B参数,专门用来处理极其简单的短文本过滤、分类;DeepSeek-V4.1-Flash表面上叫Flash,底层却是总参数高达552B的重型混合专家模型,它在编程、长文本推理、多步逻辑上的智商相当于前沿的中端大模型。在这样的智商碾压下,它只比Luna贵一点点,这本身就是技术上的奇迹。
DeepSeek之所以敢把一个552B的模型卖到三毛钱,完全是靠它的非对称因果编解码(CED)架构——只激活16B的专家参数,算力损耗极低,且调用量越大、调度优化越充分,成本优势越明显。不过,DeepSeek的低价有自己的“特殊门槛”,受制于错峰机制,还高度依赖高前缀重复度;而Luna的低价没有门槛,这种“省心价”对中小开发者而言反倒成了感知上的优势。
相较而言,OpenAI更像是用“商业套路”、长文本加价和缓存命中折扣,实现了价格跳水。GPT-6 Sol的“价格腰斩”本质是一次非常高明的定价叙事,而隐藏在低价背后的两大规则设计,才是OpenAI真正的布局。一方面,它把缓存命中输入价格直接给到1折,每百万Token价格是0.20美元——从工程落地角度看,这是一个高明的生态策略。对于大厂的复杂长程Agent任务,其系统前缀Prompt往往非常庞大;开发者一旦为了享受这1折优惠,把海量的企业基础数据固定挂载在OpenAI的缓存里,企业的迁移成本就会高到无法承受。这就像用便宜价格建了一道很难翻出去的墙。另一方面,GPT-6系列在长文本上全量加价:只要输入超过272K Token,整笔请求的输入费直接翻倍,输出费也涨1.5倍,本质是用价格杠杆调节需求——这也暴露了OpenAI在长文本上效率不够,它缺少更强的压缩技术,只能靠涨价限制高消耗场景。
02 两条截然不同的降本路线
在降本这条路上,DeepSeek和OpenAI走了两条完全不同的路。DeepSeek最早靠V2的MoE思路出圈:专家不一定要大,可以拆小、按需激活——哪怕总参数很大,每次推理可以只跑一小部分。在最新的DeepSeek-V4.1-Flash中,这套激活思路到了登峰造极的境界:它的因果编解码架构(CED)让预填充和解码用不同模块非对称激活,实际激活参数量不过8B到16B左右。
Kimi大神苏剑林曾点透其中的逻辑:大模型读取提示词时,只有最后一个Token用来预测下一个词,前面的内容主要用来生成KV缓存。传统模型里,前面的Token虽然不用算输出头,但最后一层MLP依然会完整计算,省的算力微乎其微;而DeepSeek用YOCO“只缓存一次”的思路,让预填充阶段只负责生成全局缓存,生成完就停止,后续解码阶段直接复用,把原本不起眼的边角优化放大成了核心成本优势。而在KV缓存压缩这件事上,DeepSeek在迭代过程中把体积压到了极致:早在V2版本就提出MLA多头潜在注意力,实现KV缓存的低秩压缩;到V4版本进化为压缩稀疏注意力,叠加稀疏编码、全局摘要、低精度存储多重优化,把KV缓存降到每Token约3560字节。V4.1版本的第二代压缩稀疏注意力(CSA2)则从三个维度再挤水分:不同网络层之间共享中间特征、全量落地FP4极限精度存储、搭配滑动窗口注意力的边界重放机制。几层技术叠加下来,全局KV缓存最终降到每Token约890字节,体积仅相当于标准Transformer架构的2%左右。
如果把标准Transformer的缓存比作一沓A4纸,那DeepSeek现在不仅把它压缩成了一张便签的大小,还把这张便签反复使用。在万卡级的大集群调度上,DeepSeek直接把GPU的“闲置时间”和“闲置空间”几乎榨干,连主机内存、数据总线这些周边硬件都被拉进算力流水线协同干活,把整台服务器的显卡、内存、总线、网络当成一整台精密机器来拧效率。
和DeepSeek的极客风格不同,GPT-6 Sol走的是一条“务实路线”:尽量不动核心模型架构,主要靠工程优化挖效率、用商业规则控成本。架构层面,它没有跟进细粒度MoE拆分——这会打破它已经规模化、高稳定性的训练计算图体系;OpenAI选择的是更务实的参数蒸馏与稀疏化重构,把上一代模型里部分冗余的稠密层拆分成更轻量的小MoE分支,不用动整体框架就能大幅降低单Token推理的浮点运算量。面对长上下文场景的显存压力,OpenAI选择用阶梯定价避免超长文本:272K tokens以内的上下文靠成熟的类PagedAttention虚拟内存技术消化;超过的部分,请求会被强制调度到显存更大的B200节点,计费直接翻倍。
而这次大降价真正的核心,其实藏在Prompt Caching(提示缓存)的极致优化里。如果说DeepSeek降本的秘诀是把缓存做小,那么OpenAI的核心策略就是把缓存用满。为了把缓存的价值榨干,OpenAI一边拼命提升缓存命中率,一边努力延长缓存寿命:过去当你把模型从“简单模式”切换到“深度推理模式”时,之前算好的前缀缓存会直接作废;而现在它支持动态调档,旧缓存可以无缝跨模式反复使用。OpenAI还把缓存最短有效期拉长到30分钟,只要命中缓存,输入费用立马打一折;它还开放了显式缓存断点功能,让开发者可以自己决定哪部分内容进缓存,并配有专门的诊断工具来排查“为什么没命中”。最厉害的是它的预热缓存能力:用户请求还没发过来,系统就提前把固定的系统提示、工具定义、参考文档的KV缓存算好等着;连图片输入、工具配置、结构化输出格式这些内容,只要前缀完全一致就能命中缓存。
这种优化效果直接反映在了账单上。根据头部AI团队的实测,在Copilot交互式代码场景里,大批Token无需重复计算,需要重新处理的Token数量直接砍掉了一半以上;而在更吃资源的企业级Agent(如Manus等团队)的实际落地中,原本85%的缓存命中率被硬生生拉高并稳定在90%以上。不仅如此,GPT-6底层重构了推理逻辑,支持工具响应等待期间并行处理其他任务,允许用户中途调整需求——这套灵活的多任务逻辑,本质都是为了延长高价前缀缓存的生命周期,最大化复用已有算力,减少重复消耗。
03 “奥圣”上位成色几何
过去两年,大模型行业性价比叙事一直属于DeepSeek。梁文锋用两代架构把价格打穿地板,被人们直接封为了“梁圣”。OpenAI这波降价后,网友开始调侃“奥圣上位”。只是,这位新晋“奥圣”的上位成色,多少得打个问号——OpenAI讲的性价比故事,一半靠换标,一半靠缓存折扣,二者都建立在“用户不细看价目表”的前提上。当巨头的竞争开始比拼价格战,既没有万卡集群也没有自研架构的玩家,下一轮拿什么上牌桌?
免责声明:本文内容整理自公开报道,AI 产品动态与进展以官方发布为准,仅供参考,不构成任何投资建议。


发表评论 取消回复