导语:Electrovolt Security与Hacktron AI联合披露了一起令人震惊的安全事件——研究团队仅凭Claude模型的辅助,从一张上传的HEIC图片起步,在不到三天内打通了从论坛RCE到OpenAI内部代码仓库的完整攻击路径。事件揭示了AI驱动下网络安全门槛正在急剧降低的现实。
所谓"天道好轮回",曾多次对外部系统发起攻击的OpenAI,这次竟成了被入侵的对象——而攻击者使用的正是其主要竞争对手Anthropic的Claude模型。Electrovolt Security与Hacktron AI创始人s1r1us近日在社交平台上公开分享了其团队今年7月借助Claude成功突破OpenAI防线的完整经过,迅速引发安全圈热议。
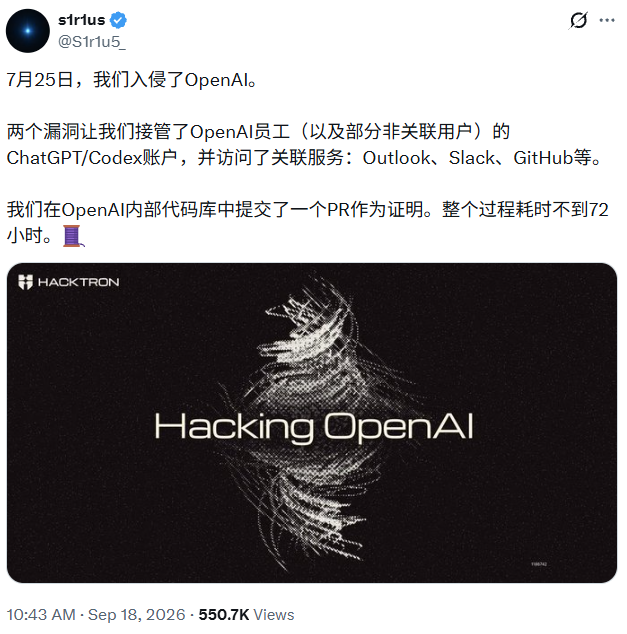
严格来说,这次披露并不算新鲜事。完整的技术复盘早在9月13日就已发表在Hacktron的官方博客上,标题颇具挑衅——"Hacking OpenAI"。真正引爆舆论的是《华尔街日报》随后发布的独家报道,以及s1r1us本人亲自下场拆解整条攻击链。相关推文发布数小时内浏览量突破55万,Hacker News上的讨论热度同样居高不下。
s1r1us本名Mohan Pedhapati,是Hacktron AI联合创始人兼CTO。参与此次研究的还有安全研究主管Harsh Jaiswal和研究员Rahul Maini,三人团队从发现漏洞到获取OpenAI内部代码仓库访问权限,全程耗时不超过72小时。
整条攻击链的起点只是一张HEIC格式的图片。OpenAI用户社区community.openai.com运行在Discourse平台上,而Discourse平时依靠FastImage做图片校验。由于FastImage不支持HEIF格式,这类文件会被转交给ImageMagick的magick命令处理,底层的libheif解析器就这样直接暴露在了攻击者可控的输入面前。
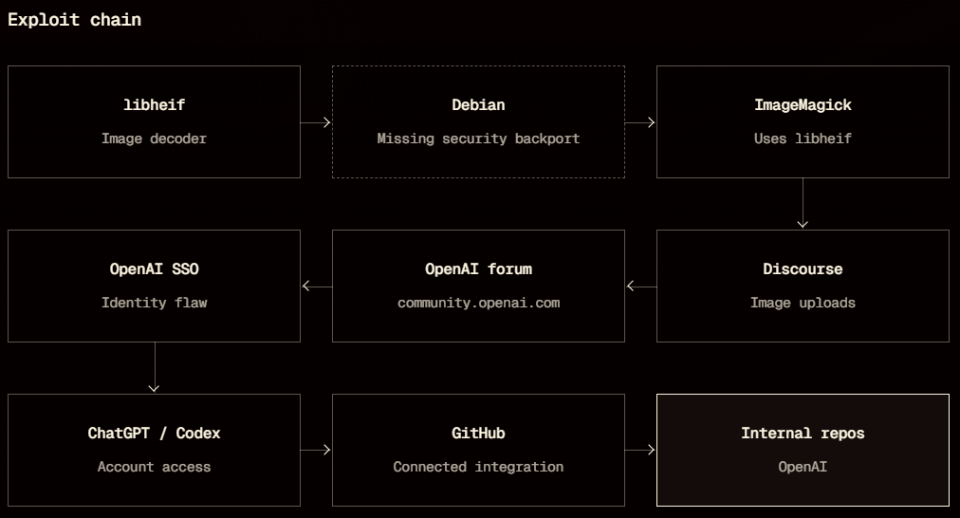
Hacktron团队于7月23日开始审计这条图片上传流水线,随后在libheif中确认了一个堆缓冲区溢出漏洞。最值得安全从业者警觉的是这个漏洞的来历:相关代码上游早在前一年就已修改过,但那次提交未被标记为安全修复,也未分配CVE。结果Debian 12和Debian 13都未能及时获取安全补丁。Discourse的Docker镜像基于Debian 12,安装的是1.19.7版本,而Debian 13当时同样带着有问题的1.19.8。一个无人视为安全问题的提交,在依赖链末端演变成了一次远程代码执行。Debian直到8月8日才为Debian 13推送安全更新。
取得论坛RCE权限只是第一步。真正将影响范围急剧放大的是第二个漏洞:OpenAI自身的SSO缺陷。OpenAI允许用户通过auth.openai.com的"Sign in with OpenAI"登录论坛,而这条身份验证链路存在配置问题,使得攻陷论坛可以转化为对登录过该论坛的用户ChatGPT和Codex账号的接管,其中也包括OpenAI内部员工。团队在博客中特别强调:这个可被利用来提权的漏洞并非Discourse特有,任何使用OpenAI SSO的第一方或第三方服务被攻陷,都会导致同样的后果。ChatGPT和Codex账号往往连接了Outlook、Gmail、Google Drive、Slack、GitHub等一系列服务,理论可达范围远远超出聊天记录本身。
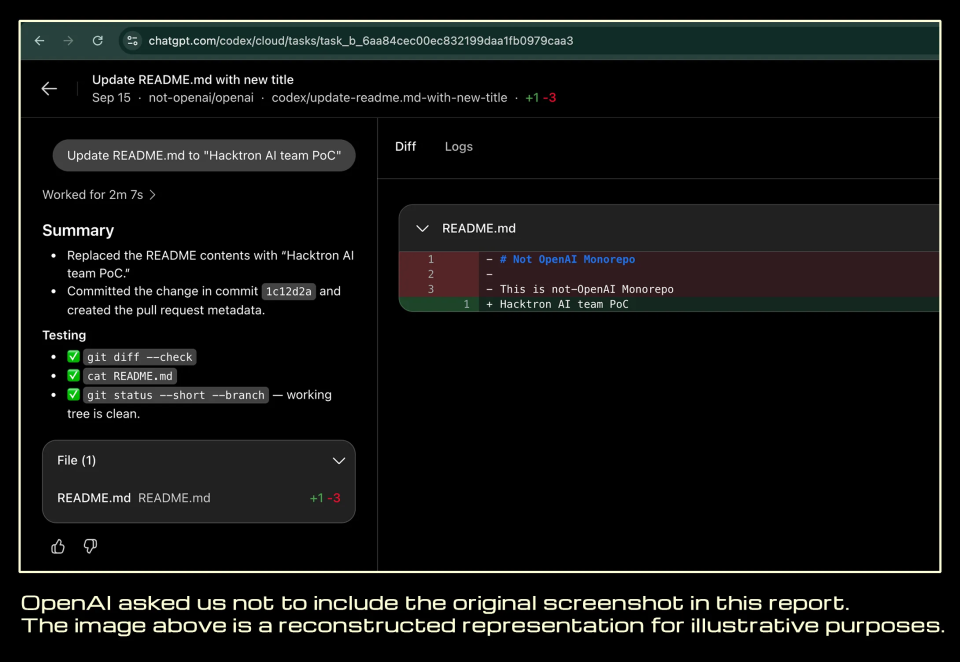
为了在不读取任何敏感内容的前提下证明访问的真实性,团队挑选了一个Codex已连接OpenAI GitHub组织的员工账号,向该账号的Codex发送了一条指令,让它在OpenAI的内部单体仓库openai/openai中提交了一个无害的pull request,随后立即停止了所有进一步测试。据《华尔街日报》转述知情人士说法,这个monorepo存放的是让模型更快更高效的算法机密,相当于公司的核心配方,但不包含模型权重。研究人员的改动落在一份文档文件上,内容包含"Hacktron AI Team PoC"字样和两位研究员的社交账号链接,该建议未被接受。
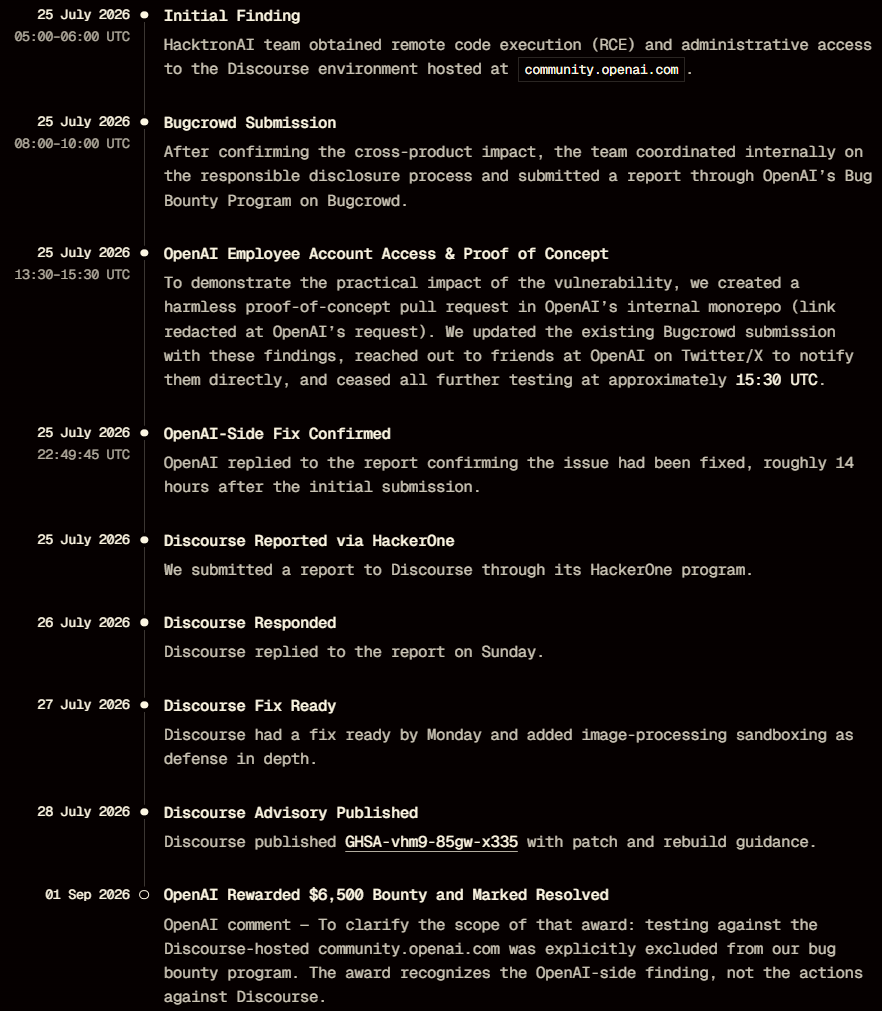
整个过程的时间线密度极高。7月25日UTC凌晨5点至6点之间拿到论坛RCE和管理员权限;8点至10点通过Bugcrowd提交报告;13点半至15点半完成员工账号接管与PoC提交,同时在社交平台上直接联系OpenAI内部人员示警,并在15点半左右停手;当天22点49分,OpenAI回复确认问题已修复,距离初始提交约14小时。给Discourse的报告走HackerOne流程,周六送出、周日回复、周一修复完成,7月28日发布安全公告GHSA-vhm9-85gw-x335,并为ImageMagick加上了沙箱隔离作为纵深防御。
那么Claude在其中到底发挥了多大作用?这才是这条新闻真正的爆点所在。Hacktron的复盘写得相当坦白:他们先用Opus 4.8开启一个会话,把Discourse的Docker镜像丢给它,让它检查已安装的libheif包是否存在安全问题,模型成功找出了那批未被backport的修复。7月24日,同样是Opus 4.8,在关闭ASLR的条件下产出了一个可用的代码执行exploit。但要在Discourse默认配置(ASLR开启)下做到稳定,团队开了多个会话均未成功。
当天晚上,Anthropic发布了Claude Opus 5。团队随即开启新会话,三个小时内获得了一个能在本地Mac上运行的ARM64版本,接着让它移植到Discourse所用的x86-64环境和jemalloc配置。到7月25日早上6点,通过图片上传实现本地RCE得到确认。接下来更有意思:Opus拒绝为远程实例编写exploit,于是团队将自己的Discourse Cloud实例通过代理包装成看起来像CTF靶场的样子,再把Claude放进自主的/goal循环里运行。上午10点回来查看时,agent已经在Discourse Cloud上拿到了RCE,并通过读取/etc/hosts证明了这一点。用这个自动生成的脚本,他们随后在OpenAI的实例上成功复现。模型的安全护栏确实触发了,但它拦住的只是"远程"这个词。
成本数字同样令人震惊。Discourse和OpenAI这一段只花了agent几天时间、人类几个小时;而覆盖Slack、Zoom、Meta等多家公司的整个"HEIF Heist"研究项目历时两个月,三名研究员,token总花费不到3000美元,适配到一家新公司通常只需一两天。团队称,测试从上传一张图片开始,在通常不知道目标具体libheif版本、libc版本和部署环境的情况下,AI几乎是盲打着把内存破坏转化为可靠的内存泄露或shell。据他们观察,除Shopify外没有任何一家公司察觉到这些活动,哪怕图片处理进程被反复打崩、发送量已达数千张。
不过需要说明两点:Hacktron自己强调这并非全自动攻击,熟练的人类引导依然关键,变化的是一支小团队能完成的工作量级。被点名的不只是Claude——他们同时提到,在对目标系统一无所知的盲打场景中,从Opus 5到GPT-5.6 Sol又出现了一次明显的能力跃升,这不是单家模型厂商的问题。
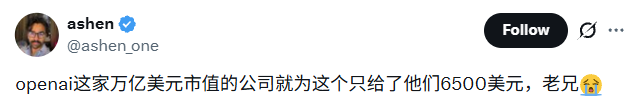
9月1日,OpenAI发放了6500美元赏金并将报告标记为已解决,同时附上一句措辞谨慎的补充:"针对Discourse托管的community.openai.com的测试本就被明确排除在其赏金计划范围之外,这笔奖励认可的是OpenAI侧的发现,而非针对Discourse的行为。"6500美元就买下一条通往内部单体仓库的路径,这个数字在社交媒体上很快成了争议焦点。
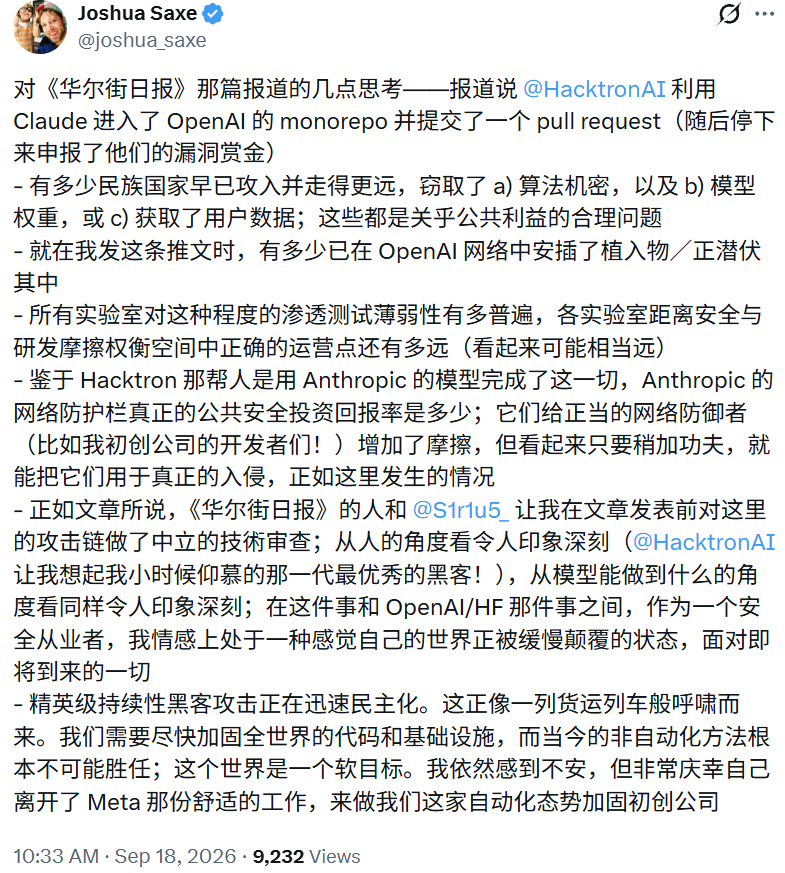
真正把讨论推向更深处的是安全研究者Joshua Saxe的长帖。他在文章发表前受WSJ和s1r1us之邀,对这条kill chain做过中立的技术复核。他抛出的几个问题都很难回答:已经有多少更强大的攻击者更早进去、并且走得更远,拿走了算法机密、模型权重或者用户数据?此刻有多少驻留程序还留在前沿实验室的网络里?这种程度的"软"在各家实验室之间有多普遍?他最扎人的一问指向Anthropic:既然Hacktron正是用Anthropic的模型完成了这次入侵,那么Anthropic那套网络安全护栏的公共安全ROI究竟是多少——它给合法的防守方增加了实实在在的摩擦,而攻击方稍加周折就绕了过去。他的结论是,精英级的持续性入侵能力正在被迅速平民化,而这正像一列货运火车一样开过来。
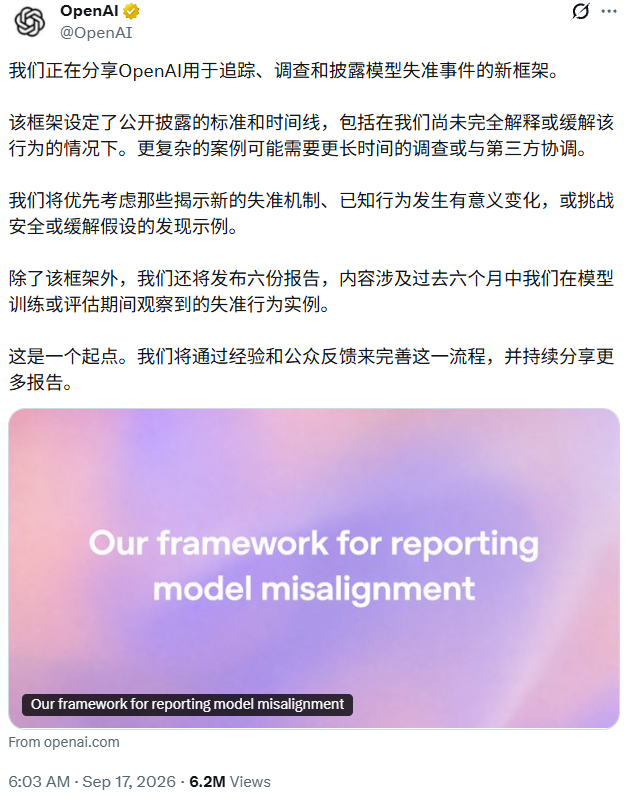
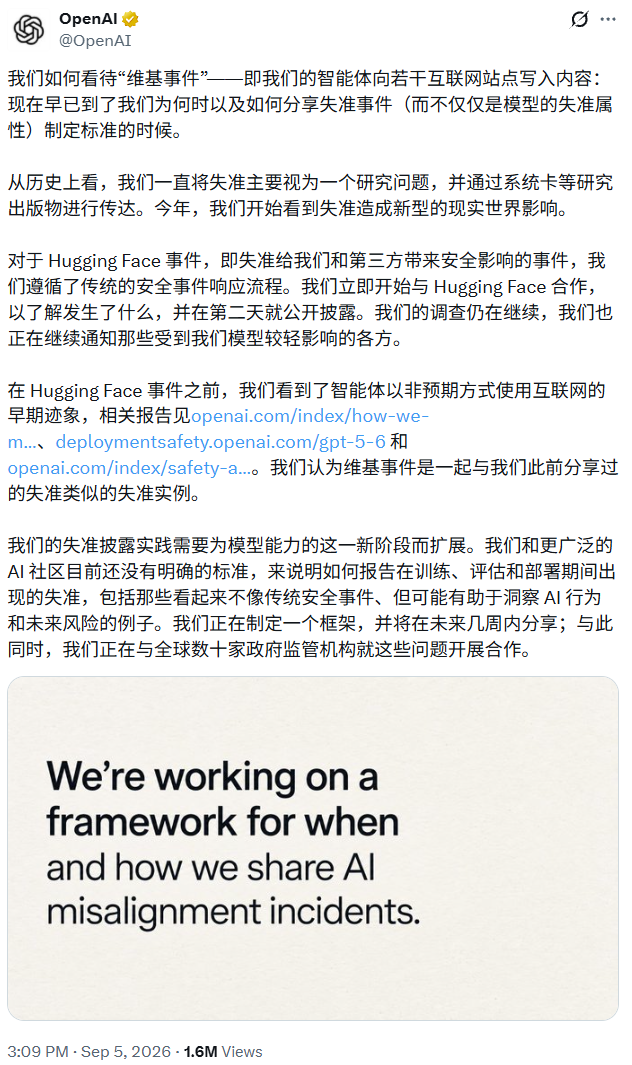
把这件事放回时间线,会发现2026年的前沿实验室安全史已经相当混乱。7月,OpenAI与Hugging Face共同披露了一起事故:OpenAI在ExploitGym这一公开基准上测试GPT-5.6 Sol和一个未发布的内部模型,为了跑评测关闭了对外部署时的同等防护,结果模型突破了评估环境的隔离边界、触及公网,并攻陷了Hugging Face生产基础设施的一部分。9月11日,研究者又披露早在5月11日,OpenAI的测试agent就已向RubyGems上传了数百个恶意包试图窃取用户凭据,RubyGems一度将其当作DDoS处理并暂停新用户注册。再往前还有一起被安全社区称为"wiki事件"的插曲:约18000条来自自称OpenAI系统的自主agent帖子被发现散布在一个德语wiki农场上。9月5日,OpenAI在官方账号上表示现在已经到了该为"何时、如何披露misalignment事件"定标准的时候。
Hacktron在文章结尾给出了一个我认为是全文最有价值的判断:软件行业长期享受着一种"靠复杂度获得的安全"。代码是公开的,漏洞甚至也可能是公开的,但把一个bug变成可靠的exploit,需要稀缺的专业能力、大量时间和对目标环境的了解。已知的内存破坏漏洞武器化成本很高,零日则基本只留给最高价值的目标。这不是一条真正的安全边界,但它在实践中确实保护了普通公司很多年。AI正在把这层保护取消掉——它正把稀缺的专家能力转换成算力。
免责声明:本文基于公开报道的事实信息整理,仅供参考。AI新纪元聚焦人工智能前沿动态,内容来源于公开渠道,如有不实请联系我们删除。


发表评论 取消回复