导语:DeepSeek V4.1 Flash彻底推翻V4架构,以非对称CED结构大幅压缩推理成本。这次重构并非单纯追求性能,而是源于Agent场景对“输入密集型”负载的全新需求。新模型由DSH“反哺”而来,预示着DeepSeek正从技术竞赛转向抢占AI入口的战略新阶段。
DeepSeek V4.1 Flash正式亮相后迅速获得广泛赞誉,梁文锋再度被社区推崇为“梁圣”。
相比V4 Flash,V4.1 Flash最核心的变化在于彻底推翻原有架构,采用了一套与前代截然不同的非对称设计方案。这意味着V4阶段积累的训练配方、优化经验与工程适配,到了V4.1阶段几乎全部失效。
对于一家已经拥有数百名研发人员的企业而言,重新搭建一套全新架构既耗费时间又消耗精力。即便如此,梁文锋依然果断拍板,对V4实施了“推倒重来”。
新架构听起来或许像营销噱头,但答案其实就藏在DeepSeek V4.1 Flash的官方论文中——旧架构已经无法承载新的训练目标。
那么这个新目标究竟是什么?我认为,很可能是“入口”。
01 | 为何选择彻底重构?
通常的流程是先有模型、再做Harness。厂商根据模型的能力特点来构建配套工具。然而DeepSeek V4.1 Flash却是被DSH“反哺”出来的。
官方论文指出,V4.1 Flash的后训练遵循标准的SFT→RL→在线蒸馏(OPD)范式,算法层面未做任何改动。所有实质性变化都集中在数据流水线——大规模自动合成Agent任务与环境,数据量、任务种类、试错轮次逐步递增。
RL训练过程中,模型在六种不同的Agent框架里反复尝试与纠错,数据规模、任务复杂度和训练轮次持续攀升。DSH是这六个训练场中最关键的一个,V4.1 Flash还专门针对DSH的不同操作模式做了定向强化。
DSH从DeepSeek V4 Pro的附属产品,一跃成为V4.1 Flash的核心驱动力。
为了满足DSH的偏好,DeepSeek V4.1采用了全新结构。论文介绍,新结构让模型在prefill阶段每token仅需激活8B参数,decode阶段激活16B,从而大幅优化了“输入密集型Agent工作负载”的成本效率。
为何“输入密集”会成为瓶颈?
过去的模型架构面向“对话”场景设计——用户提问、模型作答。输入短、输出长,模型只需记住当前一轮对话的上下文。
但在Agent时代,数十轮中间状态持续挂在上下文里,输入动辄数十万token,远超输出量。
2026年4月,密歇根大学、斯坦福大学等机构联合发布论文《AI是怎么花你钱的?》,其中指出在Agentic代码任务中,输入与输出的token比高达154:1。
于是DeepSeek决定推倒重来。V4.1 Flash采用了非对称结构Causal-Encoder-Decoder(CED)。
V4.1 Flash的语言主干共40层。若沿用传统Transformer(decoder-only)的设计,这40层应当完全相同,每层同时负责“读”和“写”,既处理输入也处理输出,且每层各自维护一份KV Cache。
CED的“非对称”,是指将这40层拆分为前20层编码器与后20层解码器。编码器只负责“读”,将输入压缩为摘要;解码器只负责“写”,依据摘要生成回答。
好比汽车生产线:过去是一个车间完成所有工序,扩产只能不断复制这一车间。现在则是流水线作业——冲压车间只管冲压,电泳车间只管电泳。
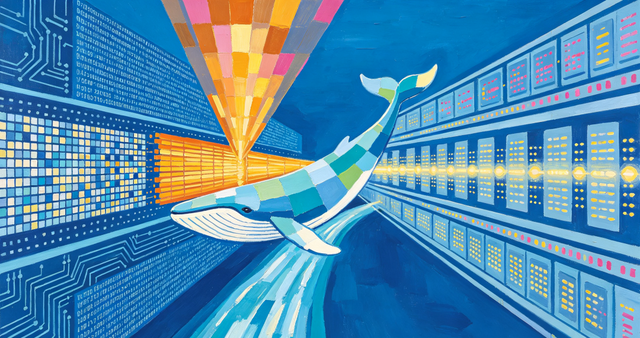
并且记忆只产生一次,解码器的全局KV Cache直接从编码器的最终结果投影得出。DeepSeek V4.1 Flash将全局KV Cache压缩至890字节/token,降低至V4 Flash的四分之一。
这得益于DeepSeek V4.1 Flash采用的CSA2(Compressed Sparse Attention 2)——第二代压缩稀疏注意力机制。
V4时代DeepSeek使用的是第一代CSA。到了第二代,不同层之间可以共享KV和索引,从根本上解决了前文所述的痛点。
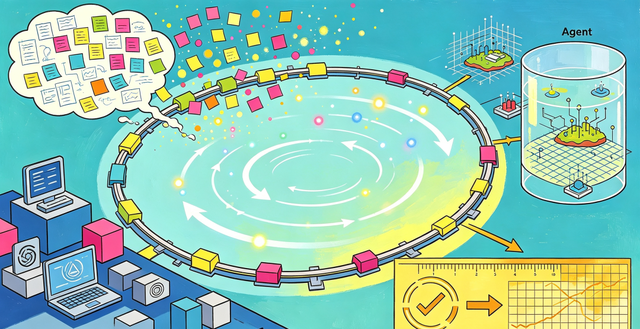
同样以汽车生产线类比,CSA2将这40层划分为三个不同的车间:Full、Reindex和Reuse。Full负责完整记录,类似传统Transformer的每一层。Reindex负责提炼重点,再据此执行任务。Reuse则直接复用Full的结果,连提炼步骤都省去了。
虽然第一层用Full、其余39层全用Reuse是最省钱的做法,但各层关注重点不同、能力各异——浅层做“字面理解”,深层做“逻辑推理”,它们需要的上下文内容截然不同。全部使用Reuse只会产出毫无价值的回答。
去年还是先有车、再修路,今年已是先修路、再造车。
模型性能强弱、性价比高低已不是叙事核心,唯有掌握入口,才能吸引更多用户。
但梁文锋并非第一个这样做的人。姚顺雨的Hy4 preview走在他前面。
Hy4 preview官方技术报告披露,通过腾讯内部的软件工程师、游戏开发者、金融分析师、安全专家,围绕他们实际交付的工作共建数据,再与CodeBuddy、WorkBuddy等产品协同设计。
在163名内部专家参与的203个真实工程任务盲测中,Hy4 preview平均得分2.99分,GLM-5.3为2.92分,Kimi K3为2.94分。
入口的重要性不言而喻,腾讯产品矩阵的优势在此得以充分发挥。
DSH和WorkBuddy本质上是同一种产品闭环,是整条训练流水线的有机组成部分。
值得注意的是,2026年7月24日,腾讯撤销大语言模型部与多模态模型部,合并成立基础模型部,由姚顺雨统一负责。他将混元多模态的发展重心放在了与Agent强相关的多模态理解上,这与梁文锋此前对多模态的看法高度一致。
如今,梁文锋又在模型层面与姚顺雨殊途同归,互相借鉴。
02 | 智谱与Kimi有类似的闭环吗?
智谱和月之暗面这两家并非没有工具——Kimi有Kimi Claw,智谱也有ZCode、AutoClaw和GLM Coding Plan。
但这些工具无法像DSH和WorkBuddy那样“反哺”模型。智谱和Kimi的工具是后挂的外壳,模型先在合成环境中练好,再套个产品给用户使用。
智谱目前把所有精力都放在了模型自进化上。8月31日,在智谱半年度业绩会上,唐杰首次明确表示,GLM-6.0是一款Full Self-Training(完全自训练)模型,与OpenAI的RSI(递归自我改进)思路相似。
唐杰表示,从预训练、中训练到后训练,全流程由模型自主完成,不再依赖人工编写代码、清洗数据、调参或设计实验。人类仅负责为模型设定目标以及做最终验收。
在GLM-5.3上,智谱已经展示了其自进化方法的一部分。GLM-5.3与5.2使用相同的基座,但性能实现了大幅提升。
具体做法是:GLM-5.3搭建了一套端到端的任务环境合成流水线,Agent从真实世界的软件工程和终端操作场景中收集种子任务,随后模型自主头脑风暴、生成大量可验证的任务草稿,再构建解题Agent,将这些草稿实例化为可运行的具体环境。
将Agent输出的回答进行精炼,依据研究员定义的评分标准检查并迭代优化任务质量。
最终产出了数千个多样化、可验证的终端Agent环境。GLM-5.3的长程任务环境数量是GLM-5.2的数十倍,而且全部由Agent自行构建。
月之暗面走的是“在自建合成环境中将Agent能力练到极致”的路线,相当于闭关修炼。
具体做法是通过AgentENV完成模型训练。这是一套基于Firecracker微虚拟机的分布式沙箱系统。
K3训练期间共运行了5100万个沙箱,支持暂停、恢复、复制和快照,专门解决长程Agent强化学习中“任务跑不完、环境容易污染”的基础设施难题。
Agent的强化学习训练与普通大模型RL存在本质差异。普通RLHF只需给模型一个prompt,模型生成回答、打分、更新参数即可,环境是无状态的,跑完即结束。
但Agent训练不同。模型需要在真实的运行环境中工作,一个任务可能执行数十步乃至数百步,耗时数分钟到数小时。
如果在执行过程中模型发现缺少某个依赖,它会自行在沙箱中安装依赖、修改配置文件以完成任务。
虽然任务完成了,但环境也随之改变,即被污染了。下一轮训练无法继续使用该环境,必须重新启动一个干净环境。重启过程约需数秒,看似不长,但在大规模训练时会浪费大量时间。
好比学开车,如果一上来就从科目三练起,必定成为马路杀手。所以需要驾校——一块没有行人和来往车辆的空地,专门练习起步、上坡和侧方停车。
AgentENV就是Kimi的驾校,让Kimi在训练时可以放开手脚,同时不受环境因素干扰。
因此智谱和月之暗面并非没有闭环,只是这个闭环未触达外界,练得再好也只是闭关修炼。
DSH和WorkBuddy都是入口,用户在真实环境中工作,数据自然回流,模型在实战中不断成长。
03 | 梁文锋要抢入口
就在DeepSeek V4.1 Flash发布的同时,DSH也宣布更新至v0.1.5版本。新版为插件作者提供了更多标准化的UI扩展入口,新增了文件上传、侧边栏文件预览等功能,优化了UI的性能与交互体验,并持续增加与模型研究前沿深度结合的实验性功能。
DSH刚发布时,与其说是产品,不如说是极客的玩具。光是安装就能劝退一大批人。
DSH的理念是“一切皆插件”——需要什么功能就自动安装对应插件,用完再卸载。结果是真正好用的插件全来自社区,包括整个UI也是如此。
到了0.1.5版本,DSH已从“框架”逐步蜕变为“产品入口”。除了适配V4.1 Flash外,其余全是面向终端用户的产品功能。
举个例子,0.1.5版本中Agent可以显式交付文件。生成的代码、文档、分析报告会直接作为文件出现在侧边栏,用户可预览、打开、定位到本地文件夹。
以往的DSH里,Agent只能将文字和代码输出到回答框,用户必须手动复制粘贴到文件中才行。
不仅如此,新版本还有一个极其实用的功能——“支持在保留已有KV Cache的情况下更新系统提示词”。
传统Agent存在一个痛点:长会话进行到一半时,若想修改系统提示词,比如让Agent从“写代码模式”切换到“写文档模式”,就必须清除整个KV Cache并重新prefill。
在1M上下文的条件下,切换系统提示词意味着Agent要花费数十万甚至上百万token去重新规划任务。
因此现有的Agent产品基本不允许中途修改系统提示词,Agent的角色和目标从会话开始就被锁定。
这说明DeepSeek正在有意识地将DSH从“极客工具”向前推进,使其成为面向更多用户的Agent产品。核心目的在于扩大入口,让更广泛的用户群体进入。
如今的DeepSeek,反而有些像卖剃须刀的吉列——刀架不赚钱甚至免费,主要靠刀片盈利。但真正锁定客户的恰恰是那个刀架。
DeepSeek也一样。想换新模型,复制粘贴一段API Key就解决了。但想换新Harness,则需要相当长的适应期。
因此DSH大量优化用户体验,不仅仅是为了继续“反哺”未来的DeepSeek V4.1 Pro乃至5、6、7、8代,更是为了抢占入口。
DeepSeek已经在朝着“入口公司”的方向迈进。
免责声明:本文基于公开报道的事实信息整理,仅供参考。AI新纪元聚焦人工智能前沿动态,内容来源于公开渠道,如有不实请联系我们删除。


发表评论 取消回复