导语:当大语言模型在文本生成赛道内卷时,前OpenAI研究员Diogo Almeida另辟蹊径,推出只做决策判断的Jev模型。这款"不会说话"的AI声称比传统大模型快193倍、成本降低444倍,但它真的代表AI新范式,还是又一个营销噱头?
九月中旬,硅谷AI圈被一个名为Jev的新模型搅动。与GPT、Claude等擅长写文章、生成代码的主流大模型不同,Jev被设计为"只判断不说话"的决策专用模型。TypeSafe AI为它定义的理念是"要决策,不要文本",彻底砍掉了大模型过去几年最核心的文本生成能力。
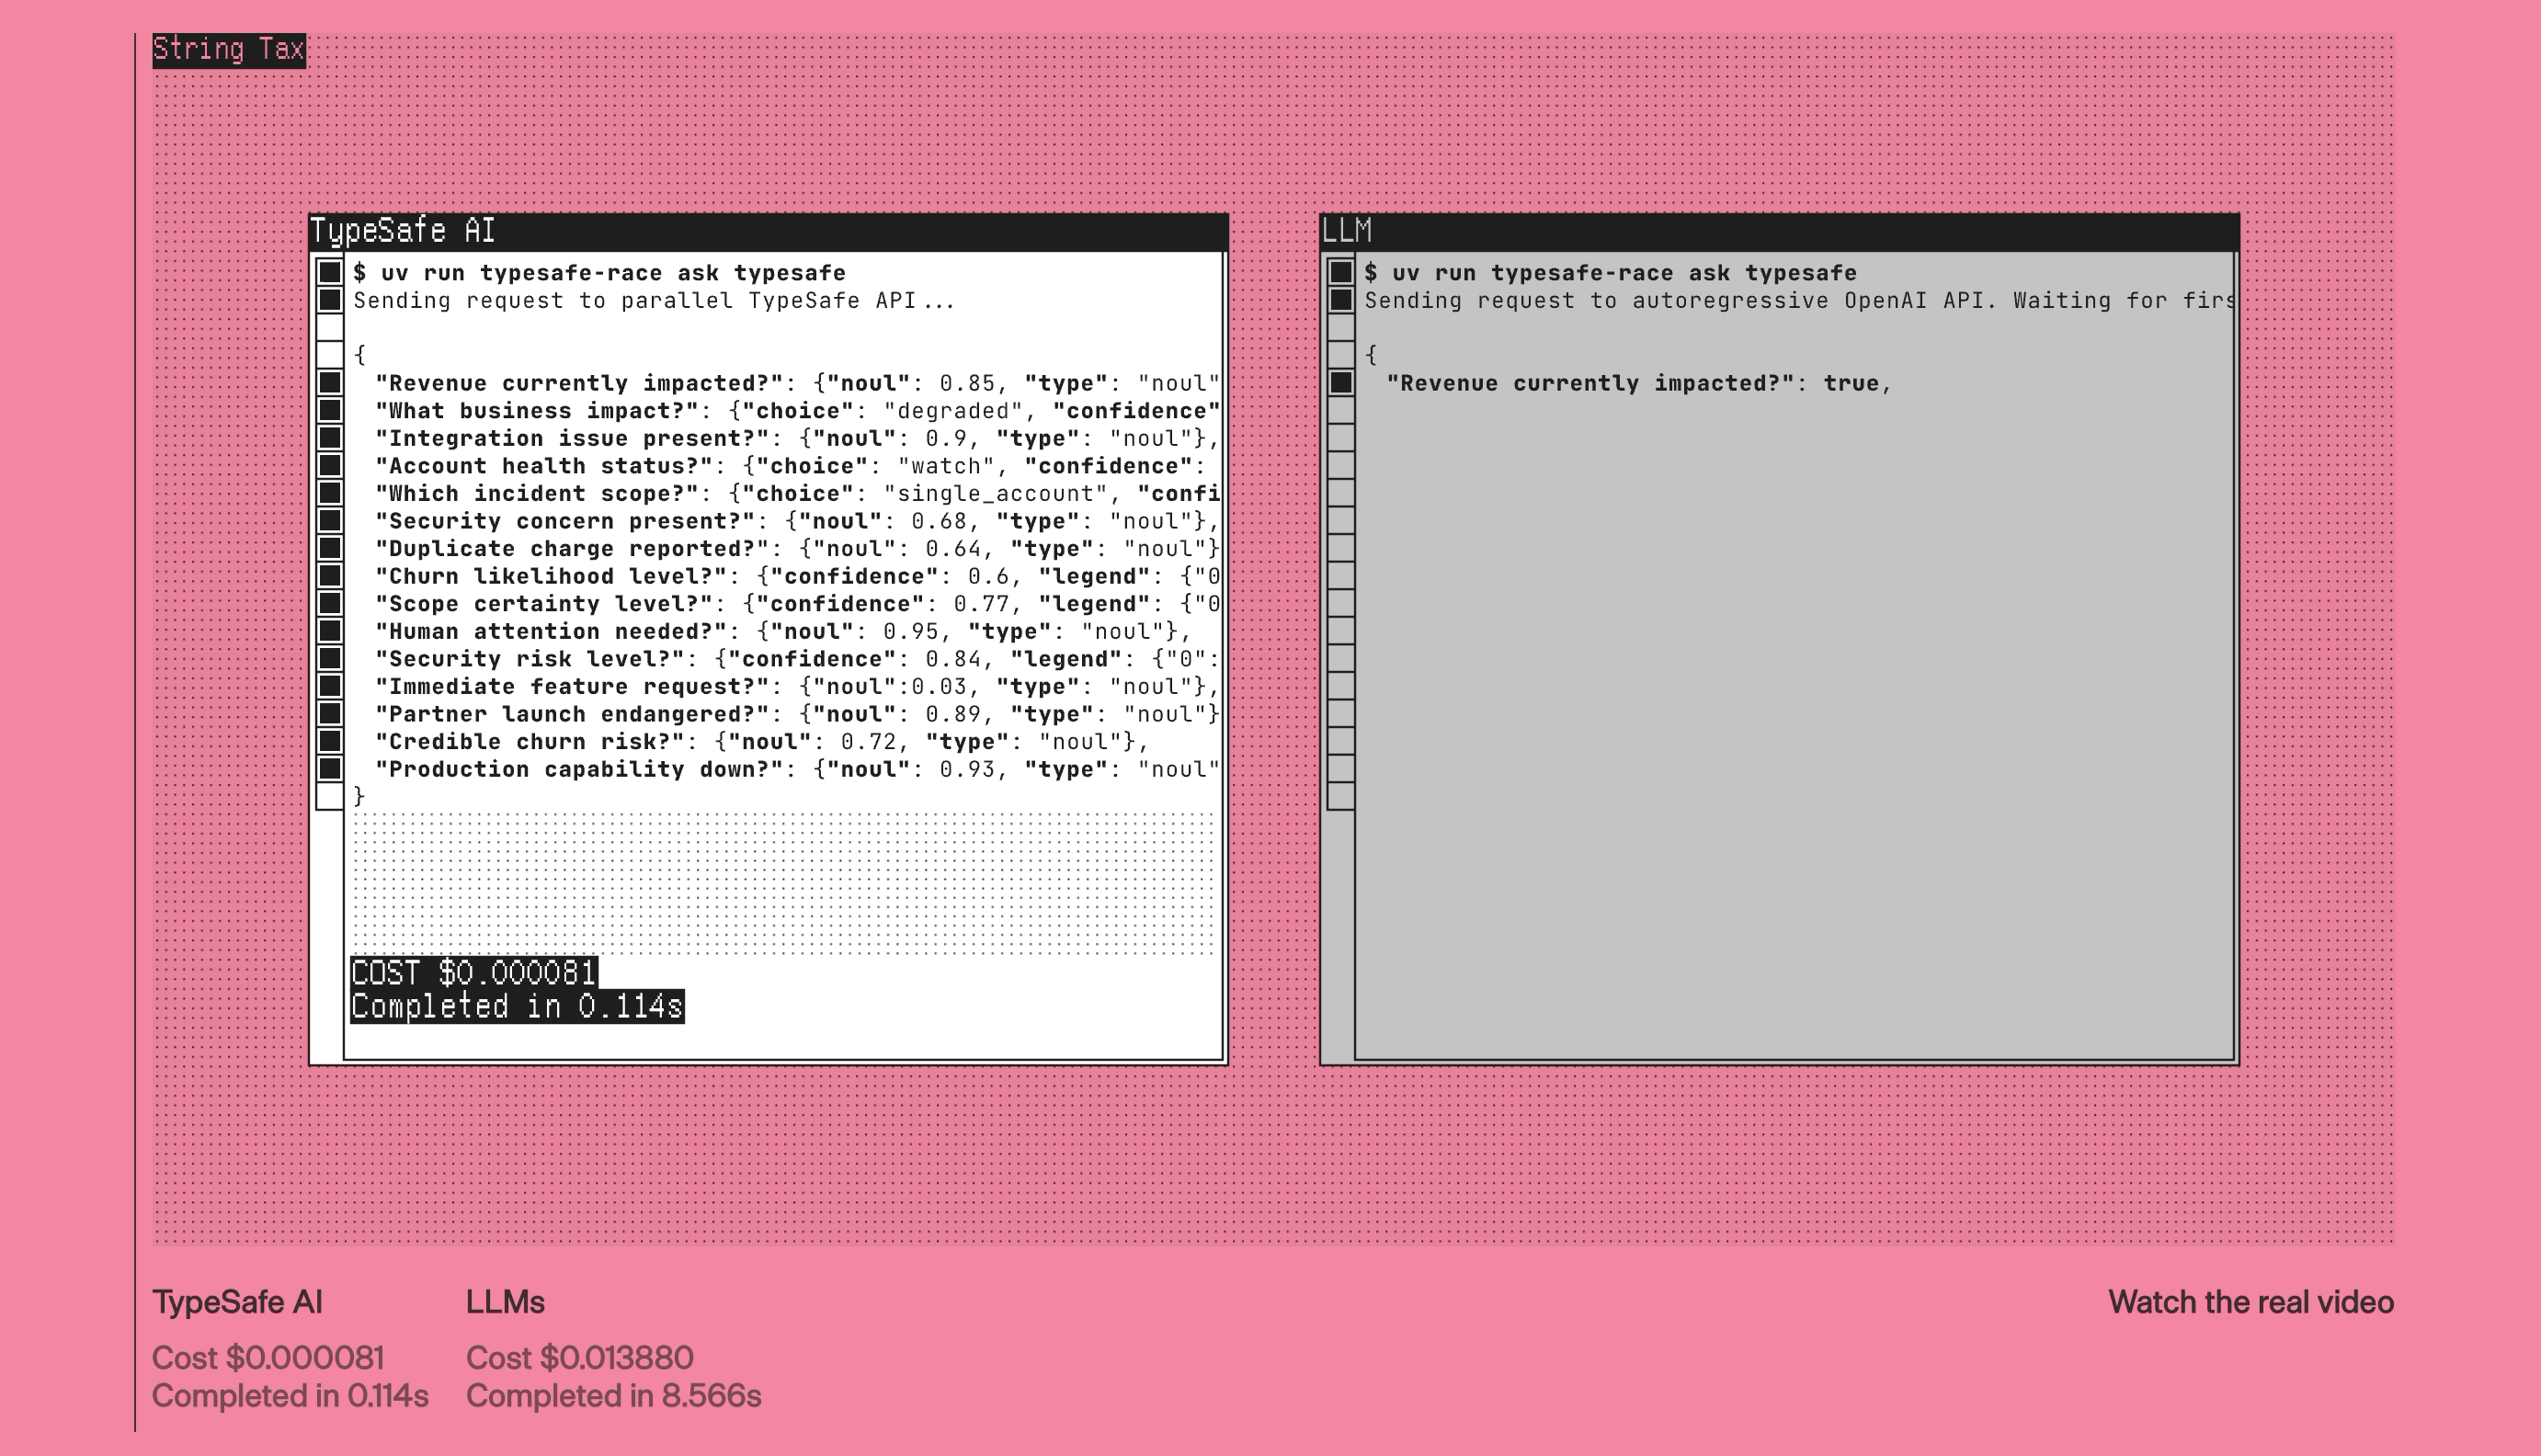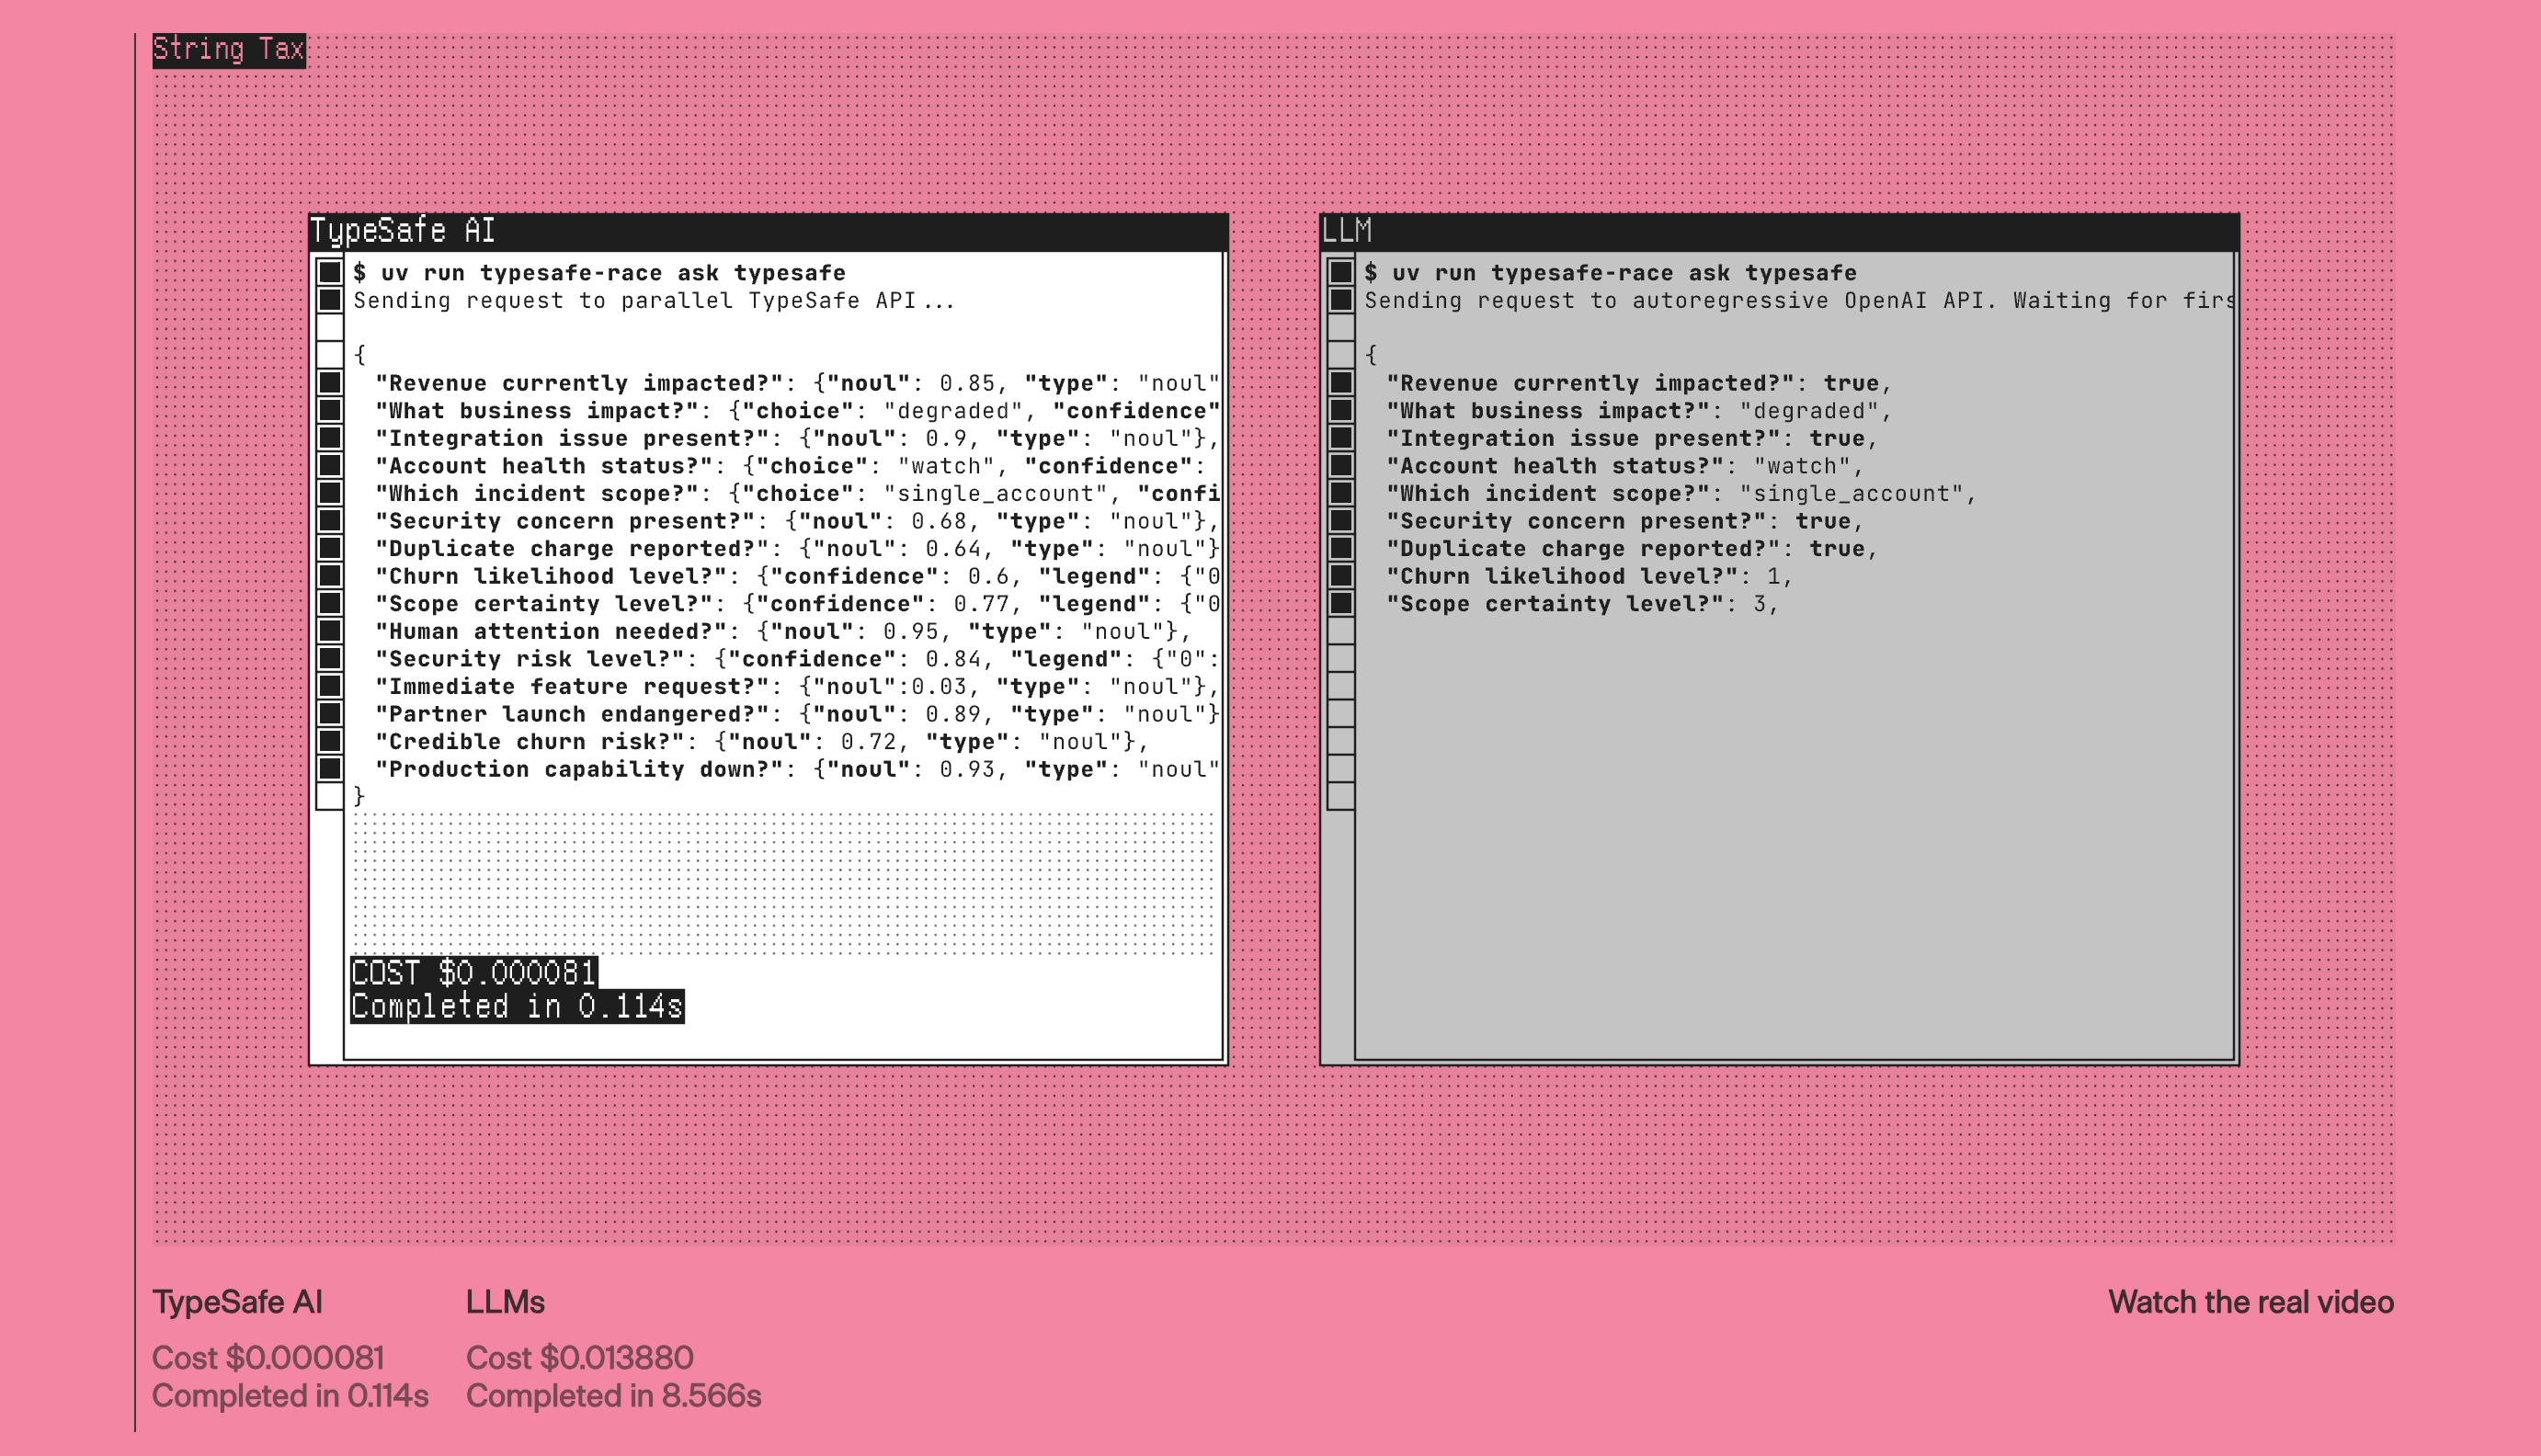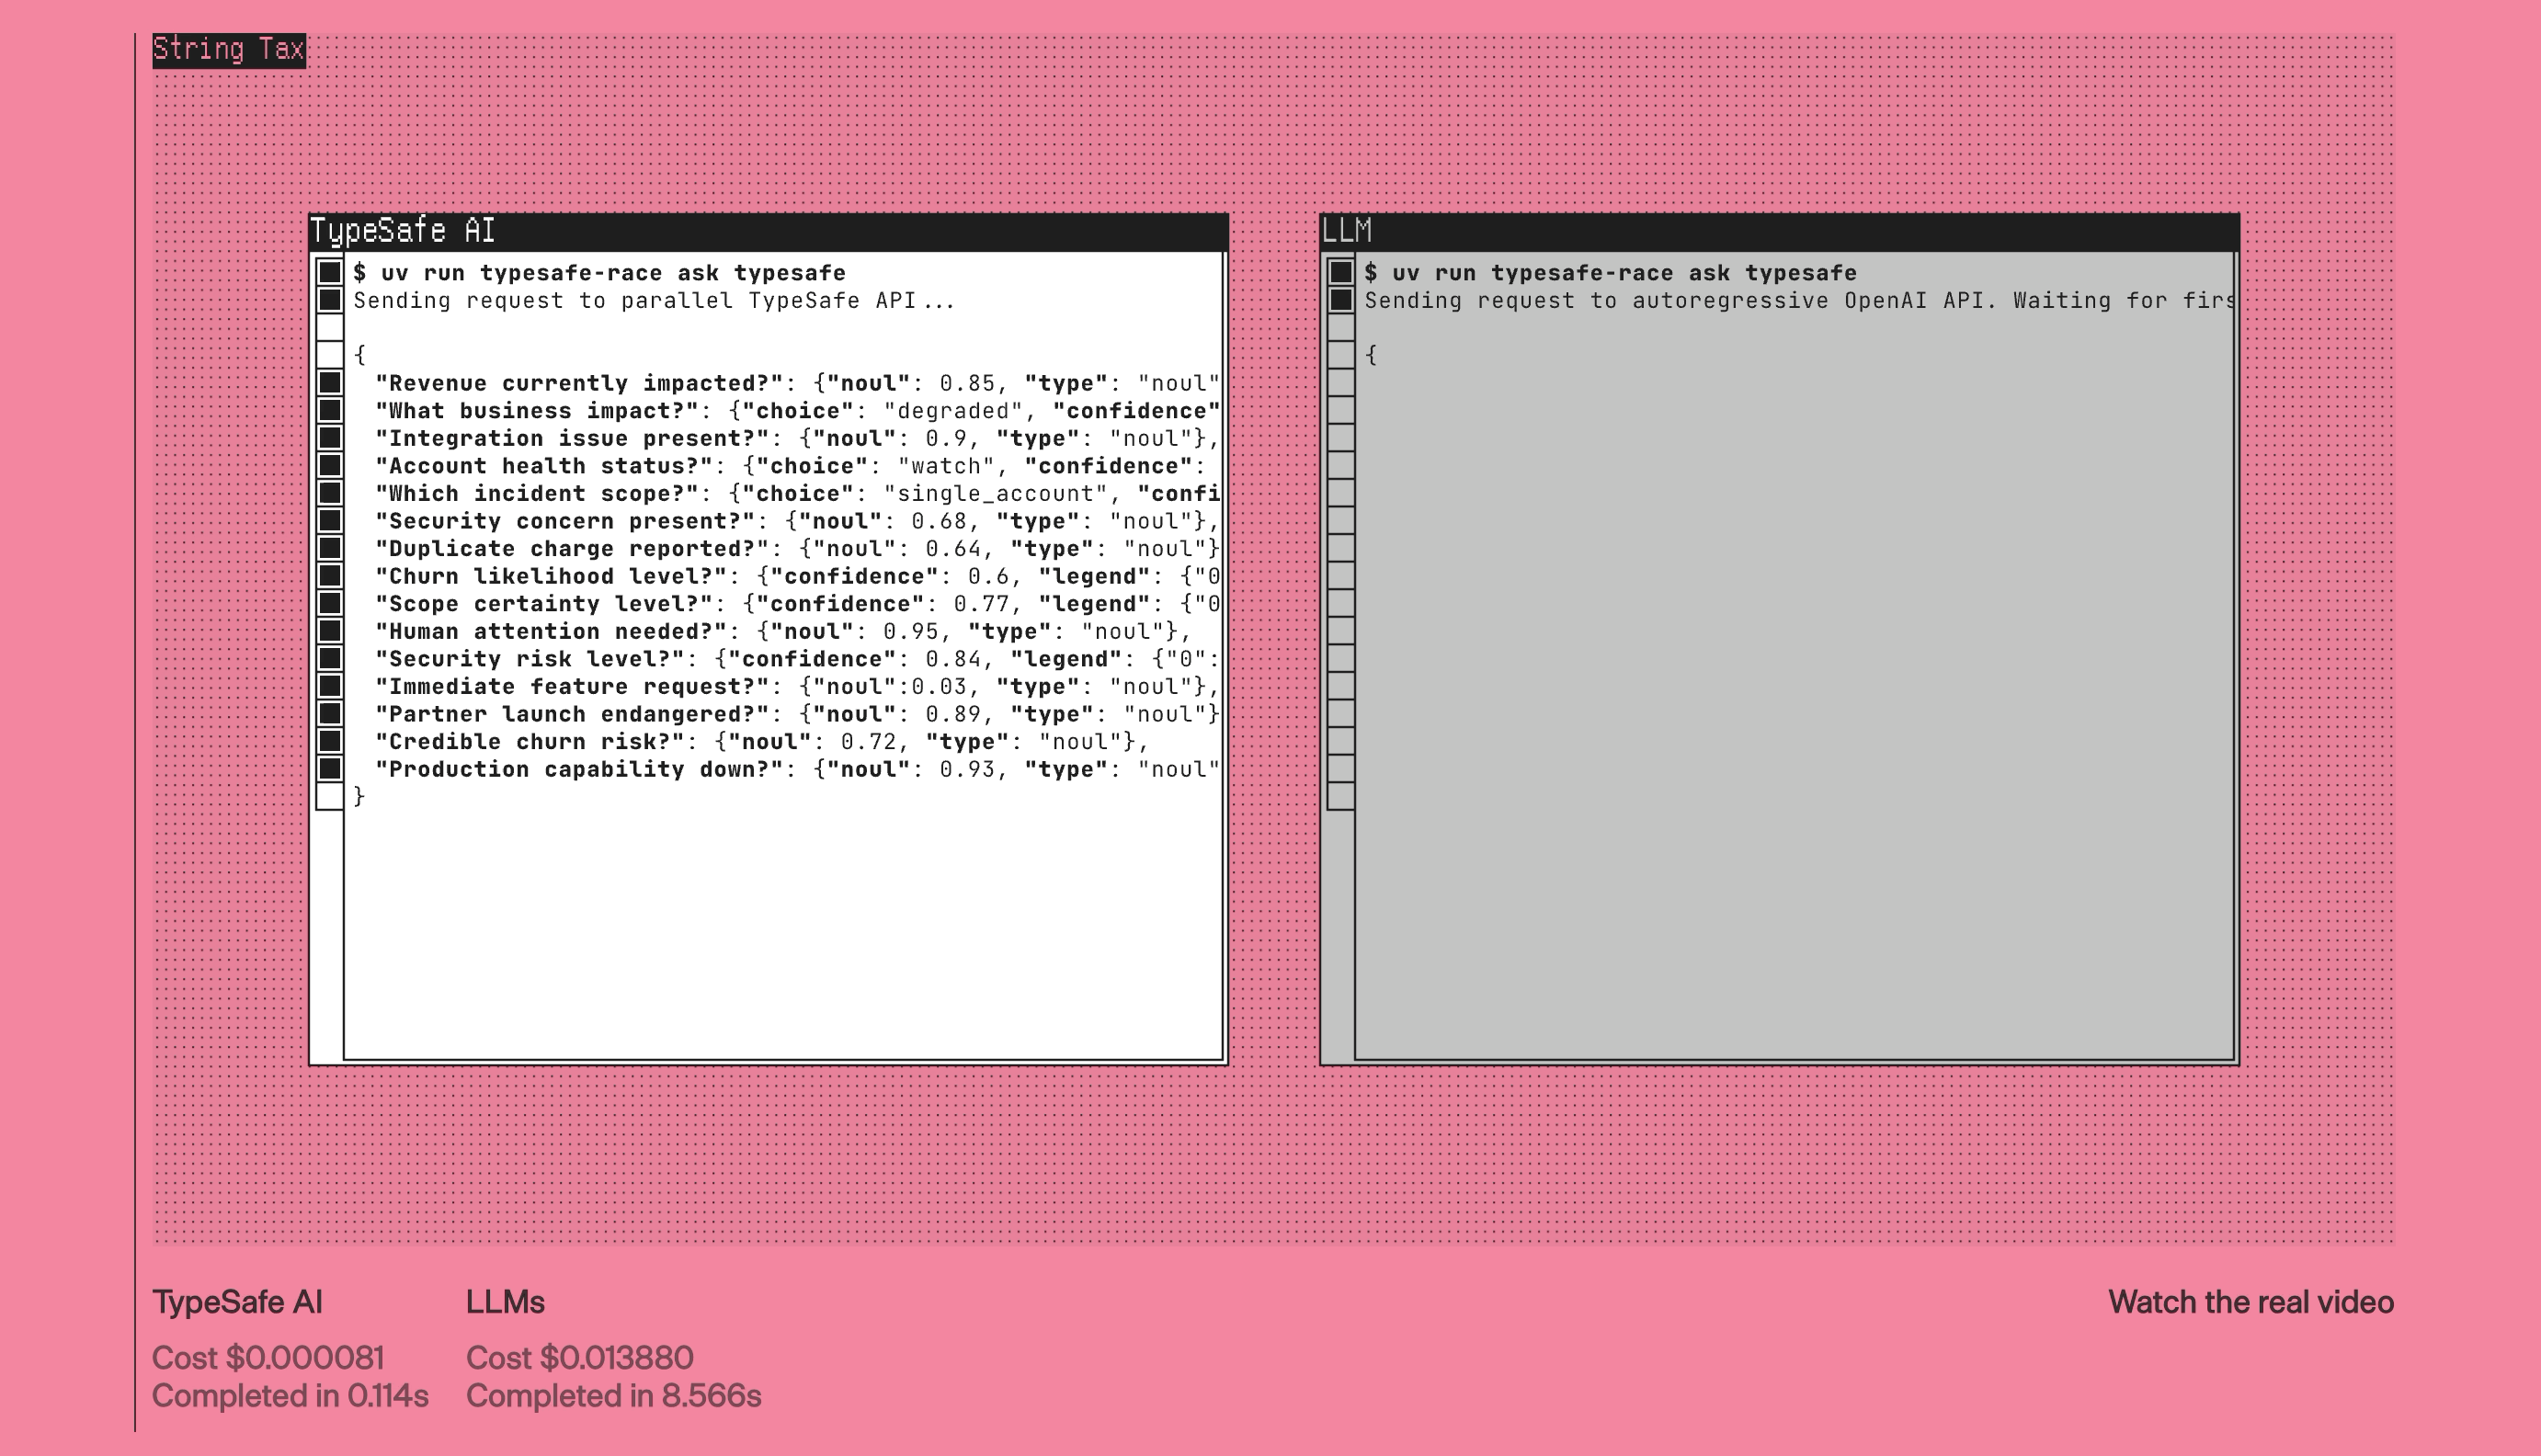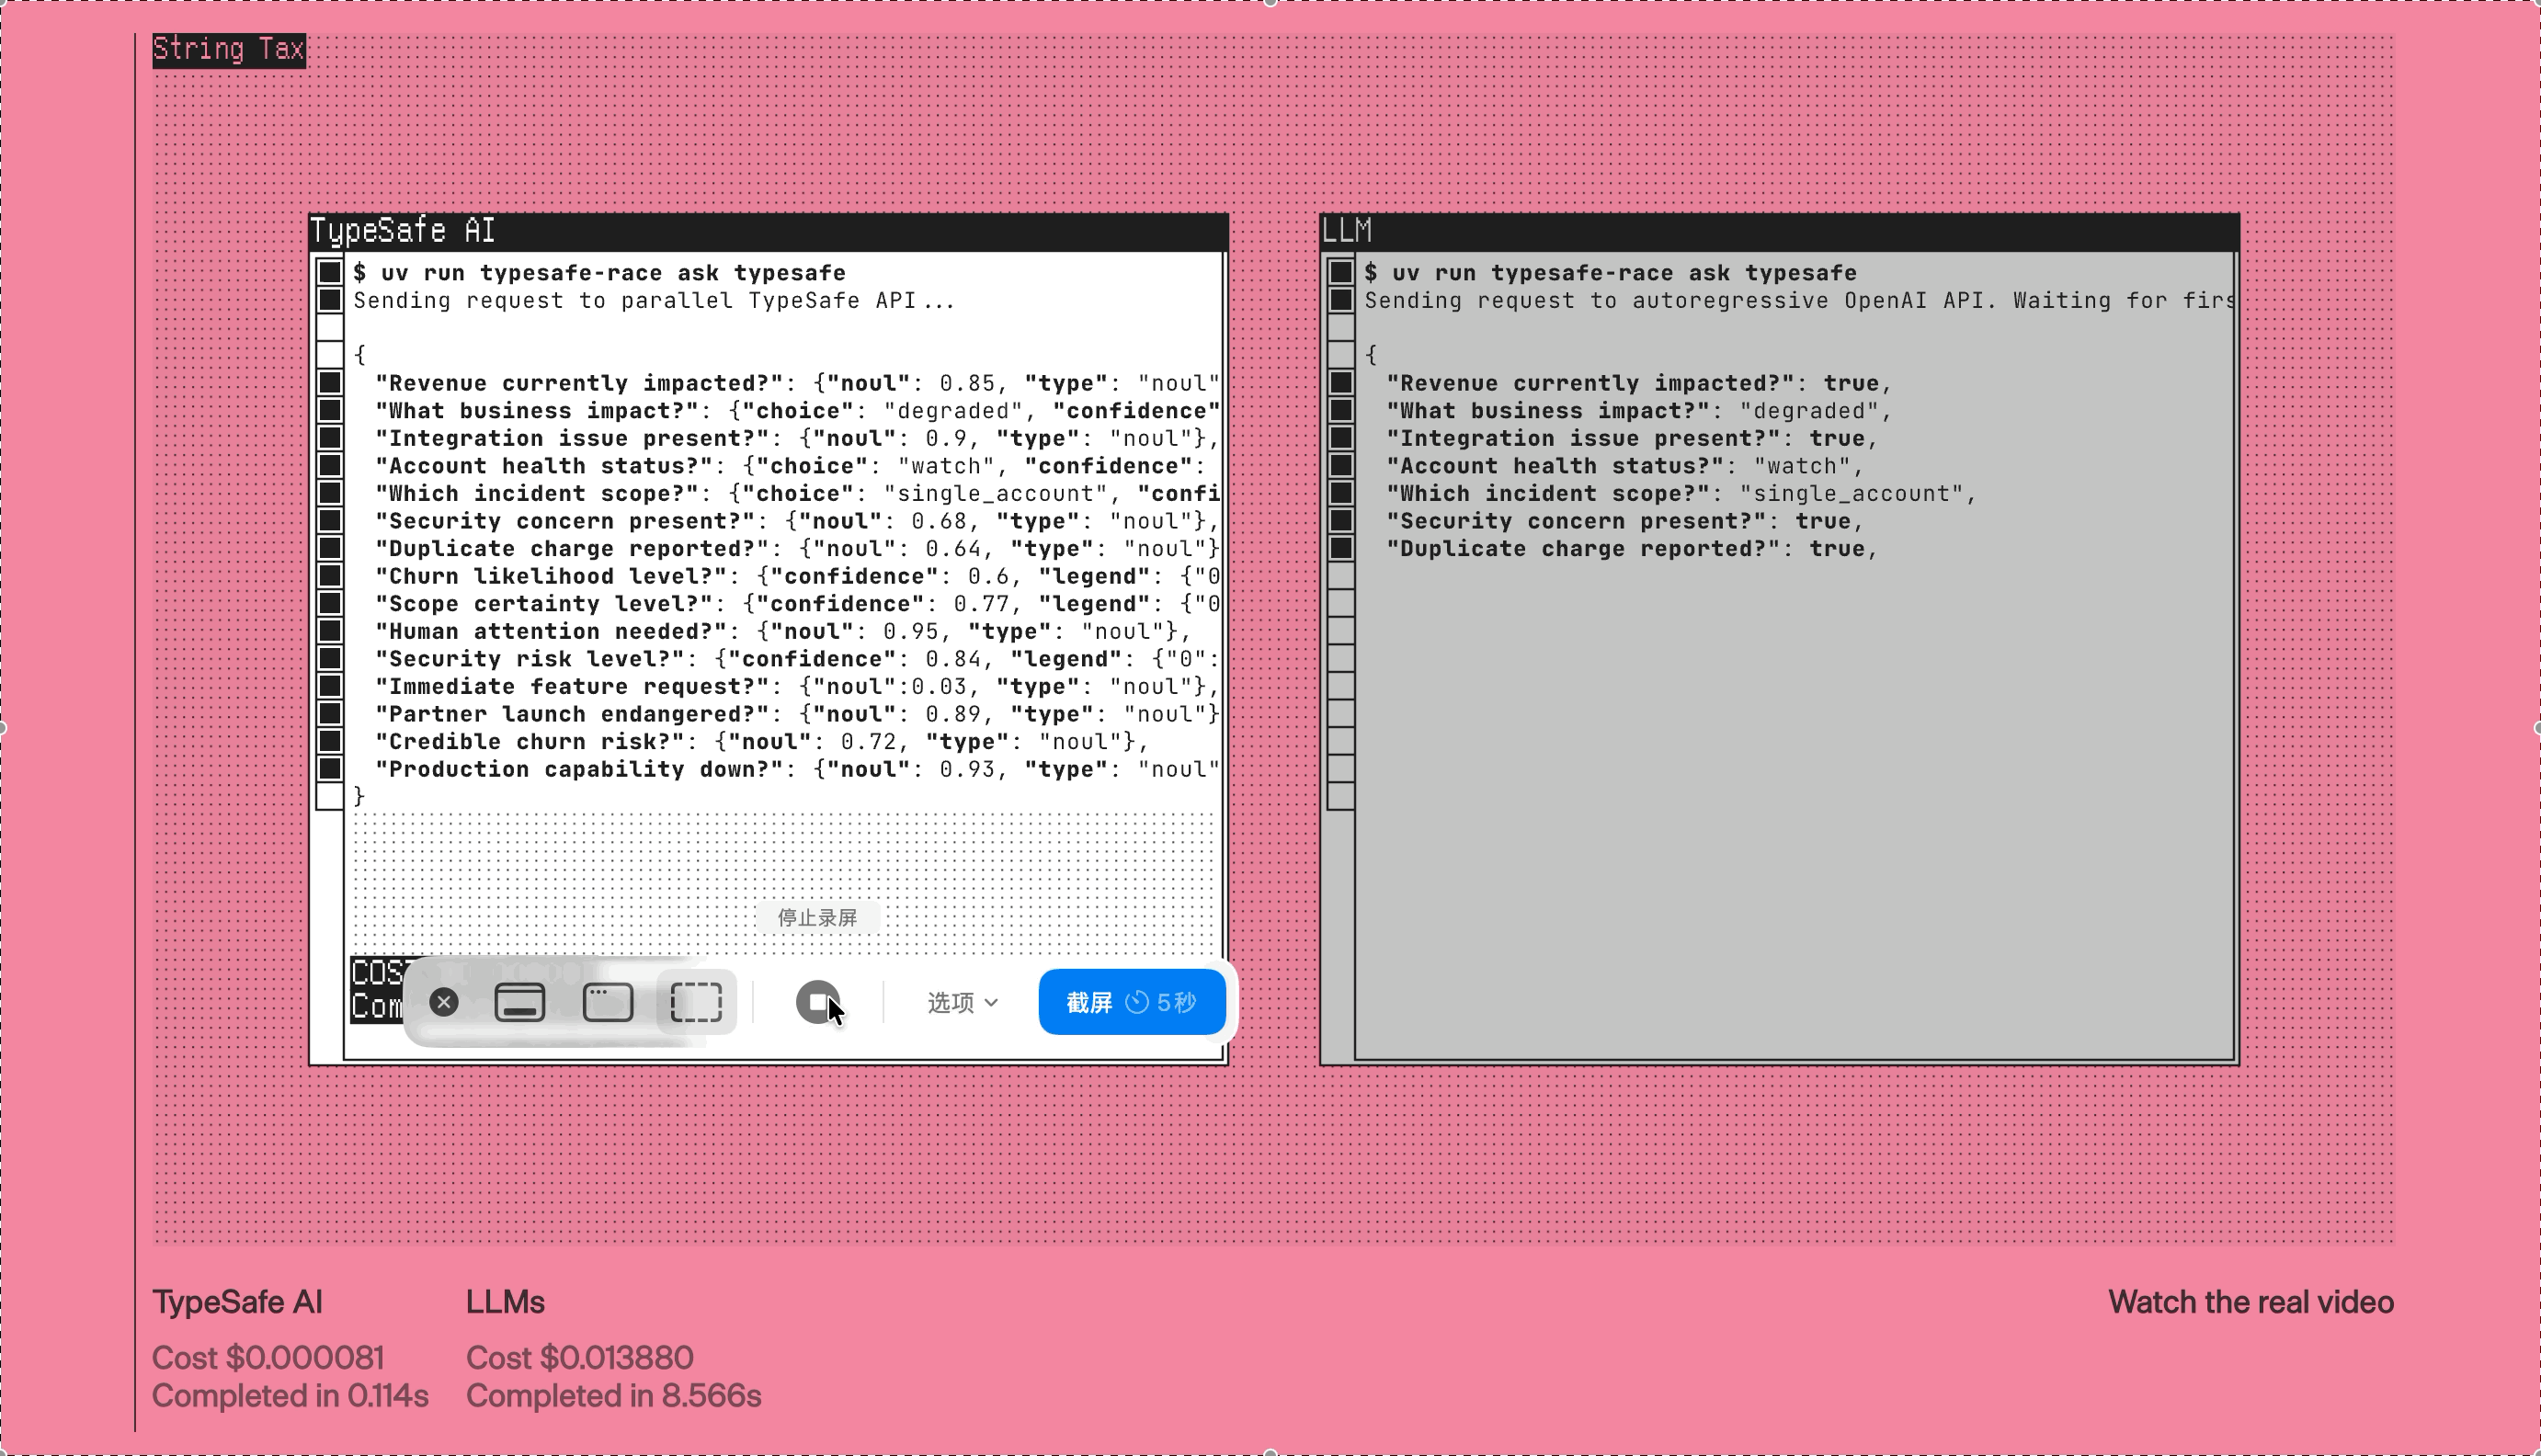
这个看起来像"高级分类器"的模型迅速引发关注。据Latent Space报道,TypeSafe发布当天长时间占据Hacker News热榜,创始人Diogo Almeida的发布帖获得约420万次浏览和近2万次点赞。性能数据更为惊人:在特定工作流测试中,Jev比对照大模型快193.6倍,成本降低444.6倍,端到端延迟70—500毫秒。
Jev背后的团队同样自带光环。TypeSafe AI由Diogo Almeida、Erik Gafni和Sasha Sheng共同创立,刚完成DCVC领投的4000万美元种子轮融资,估值约2亿美元。Almeida曾是OpenAI研究员,也是2022年InstructGPT论文的主要作者之一,参与建立了后来广泛采用的RLHF训练流程。离开OpenAI后,他花了两年时间思考:如果大模型已经如此智能,为何大多数工作仍未被自动化?
Jev正是他对这个问题的首个答案。其工作原理与传统大模型截然不同:开发者提前定义可能的答案选项,模型只需判断概率分布,无需生成自然语言。例如在客服场景,Jev可以同时判断邮件应分给哪个部门、紧急程度、退款风险及是否需要人工介入,但输出的只是结构化数据而非完整句子。
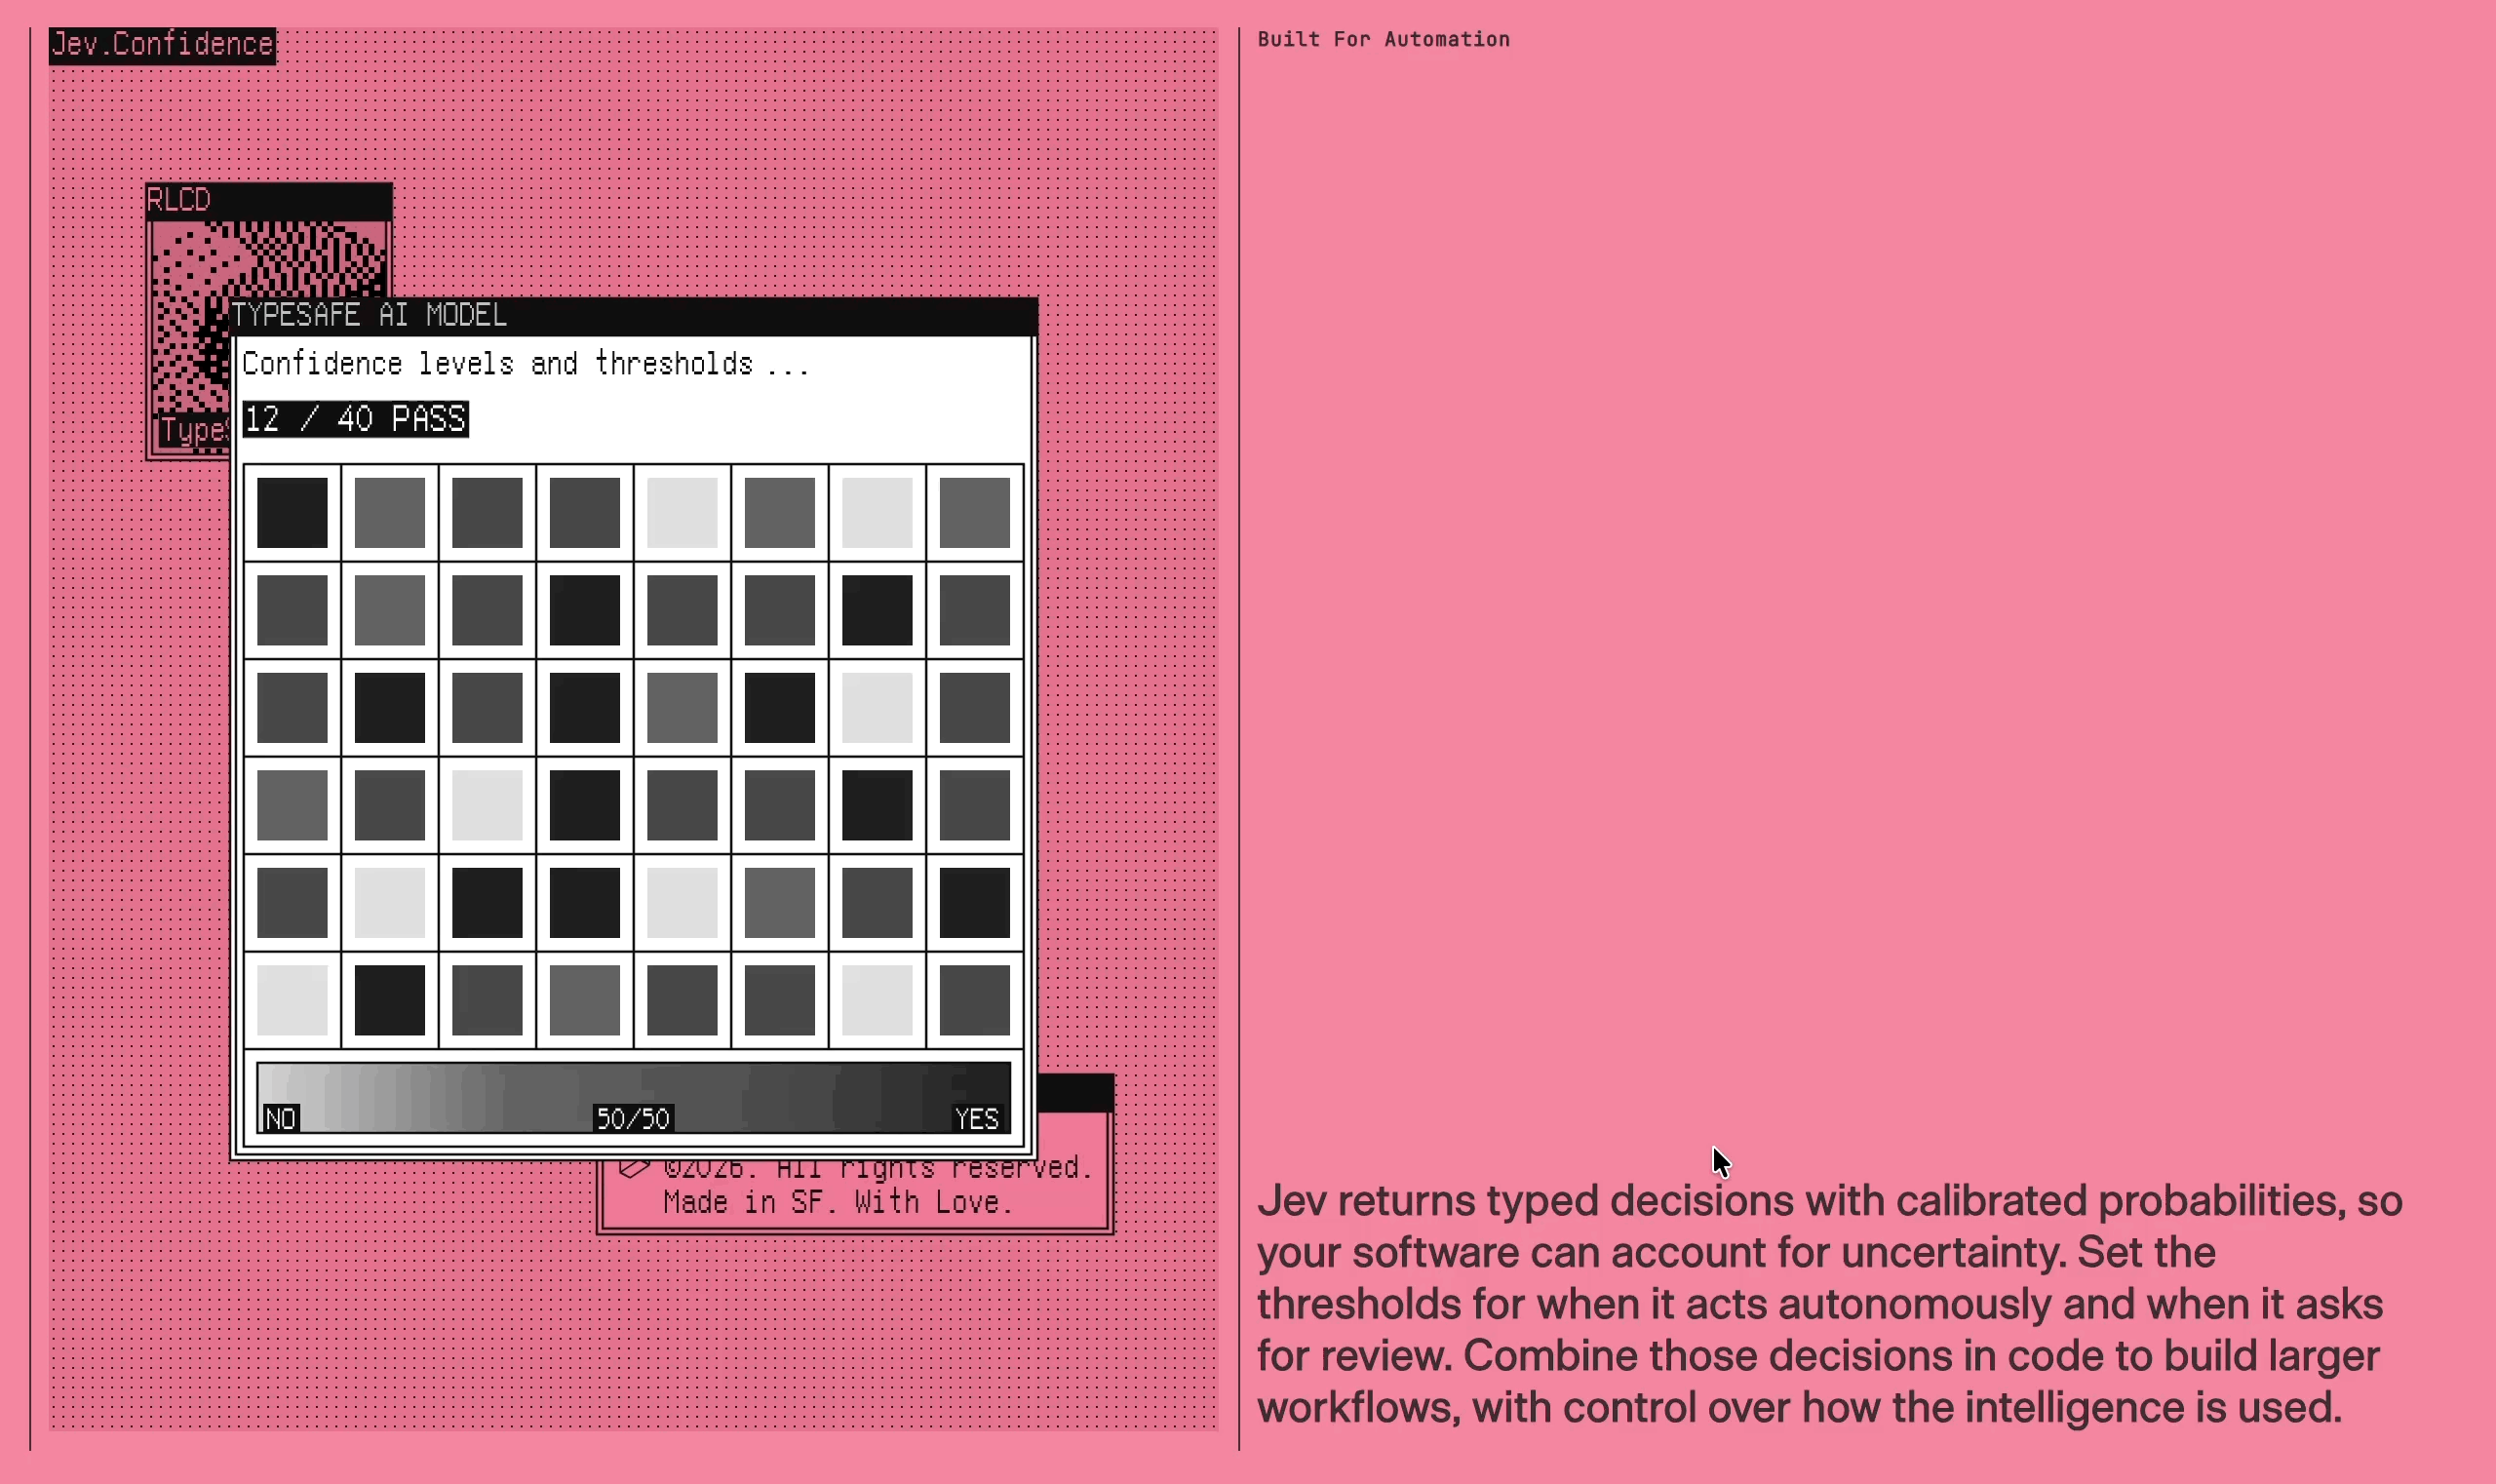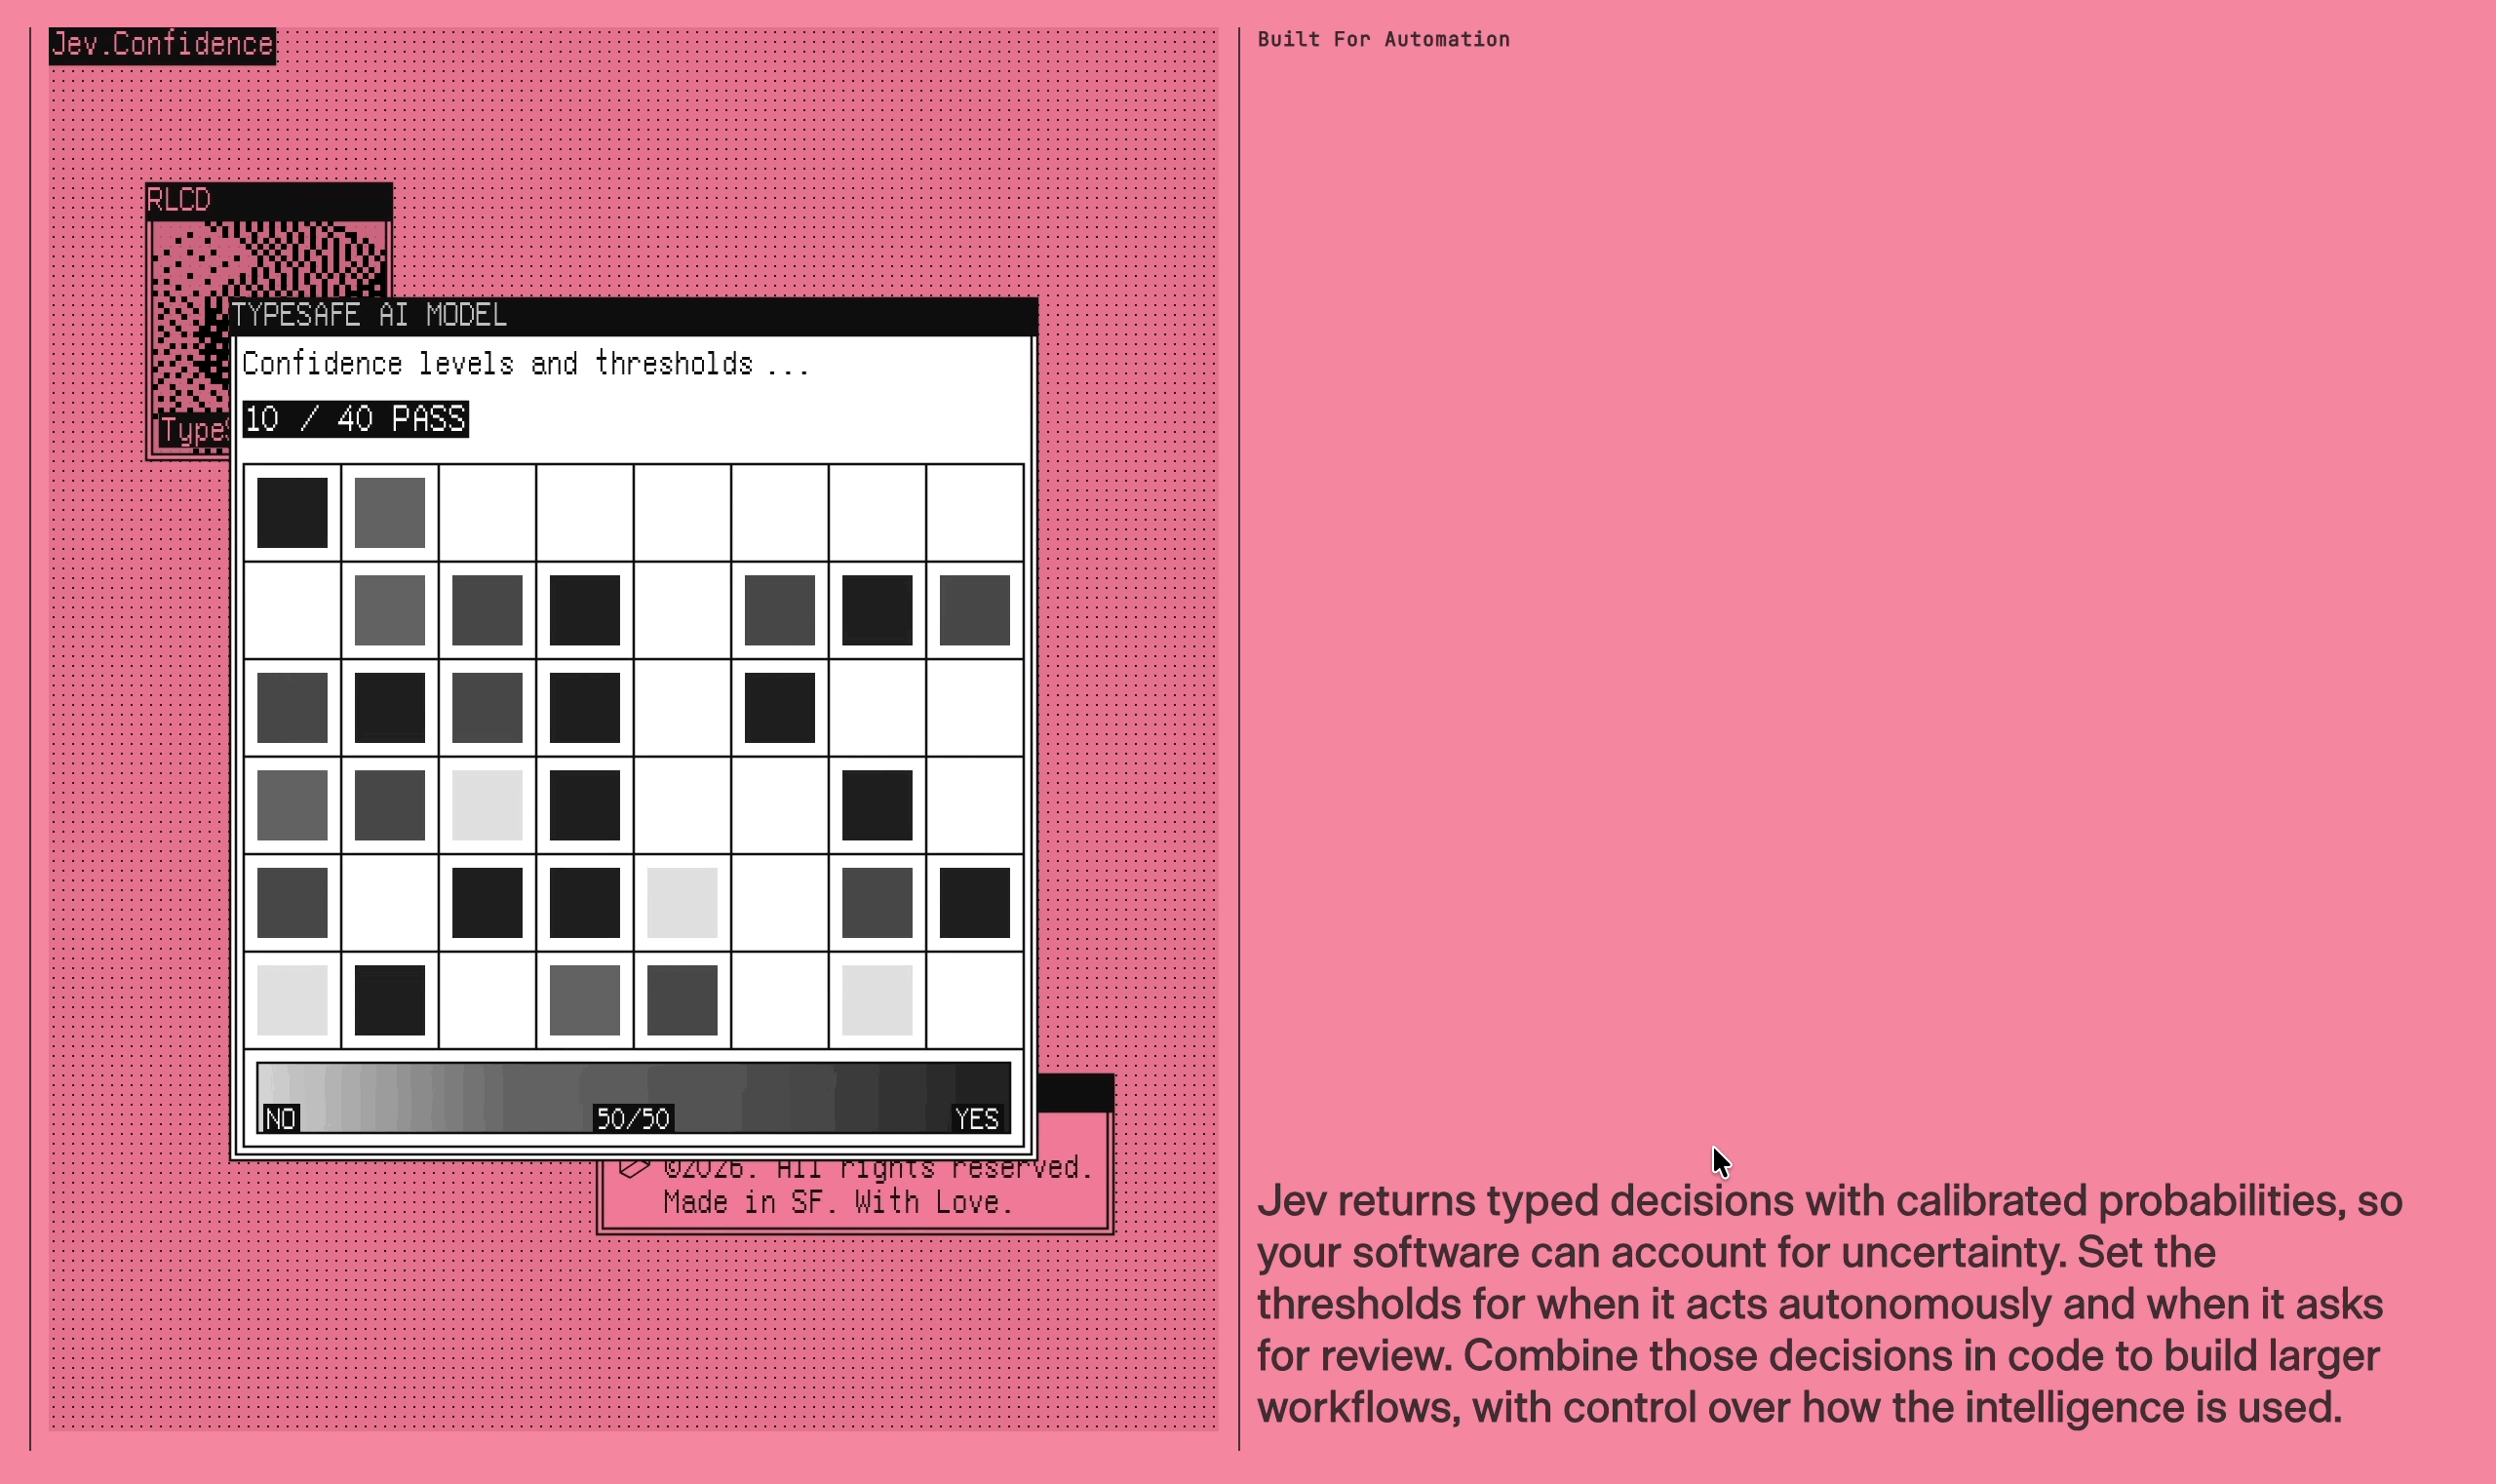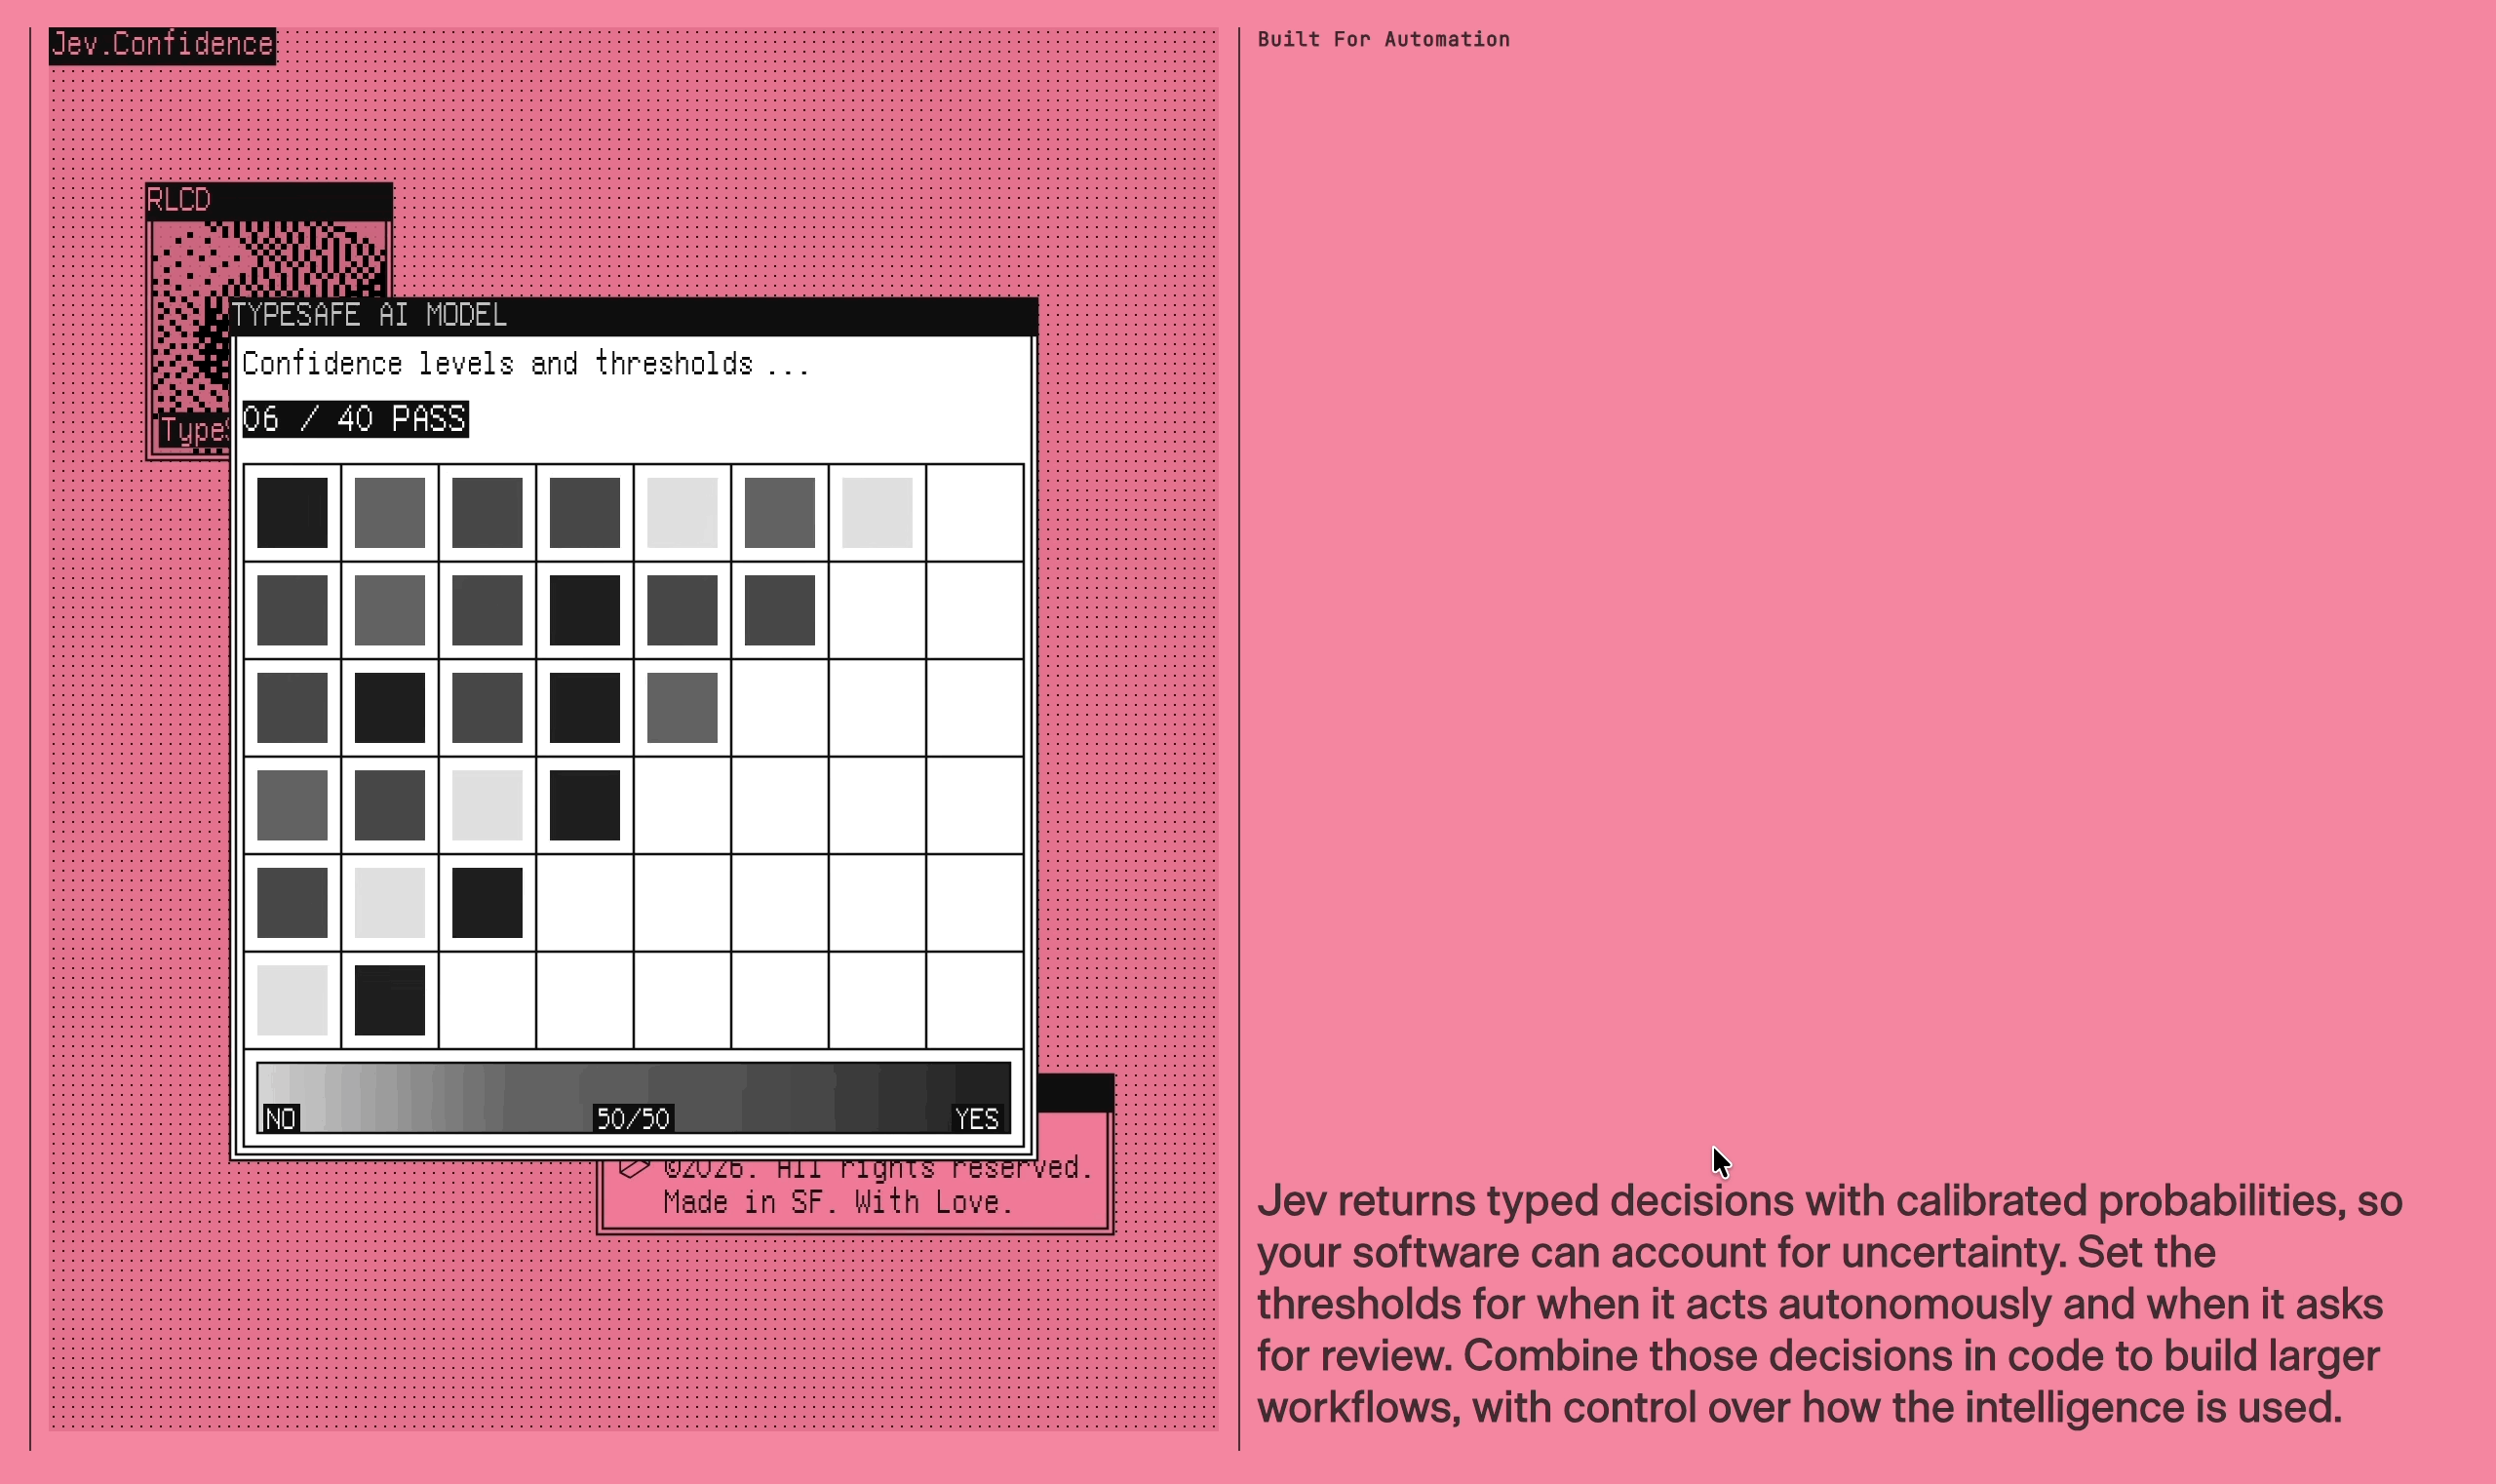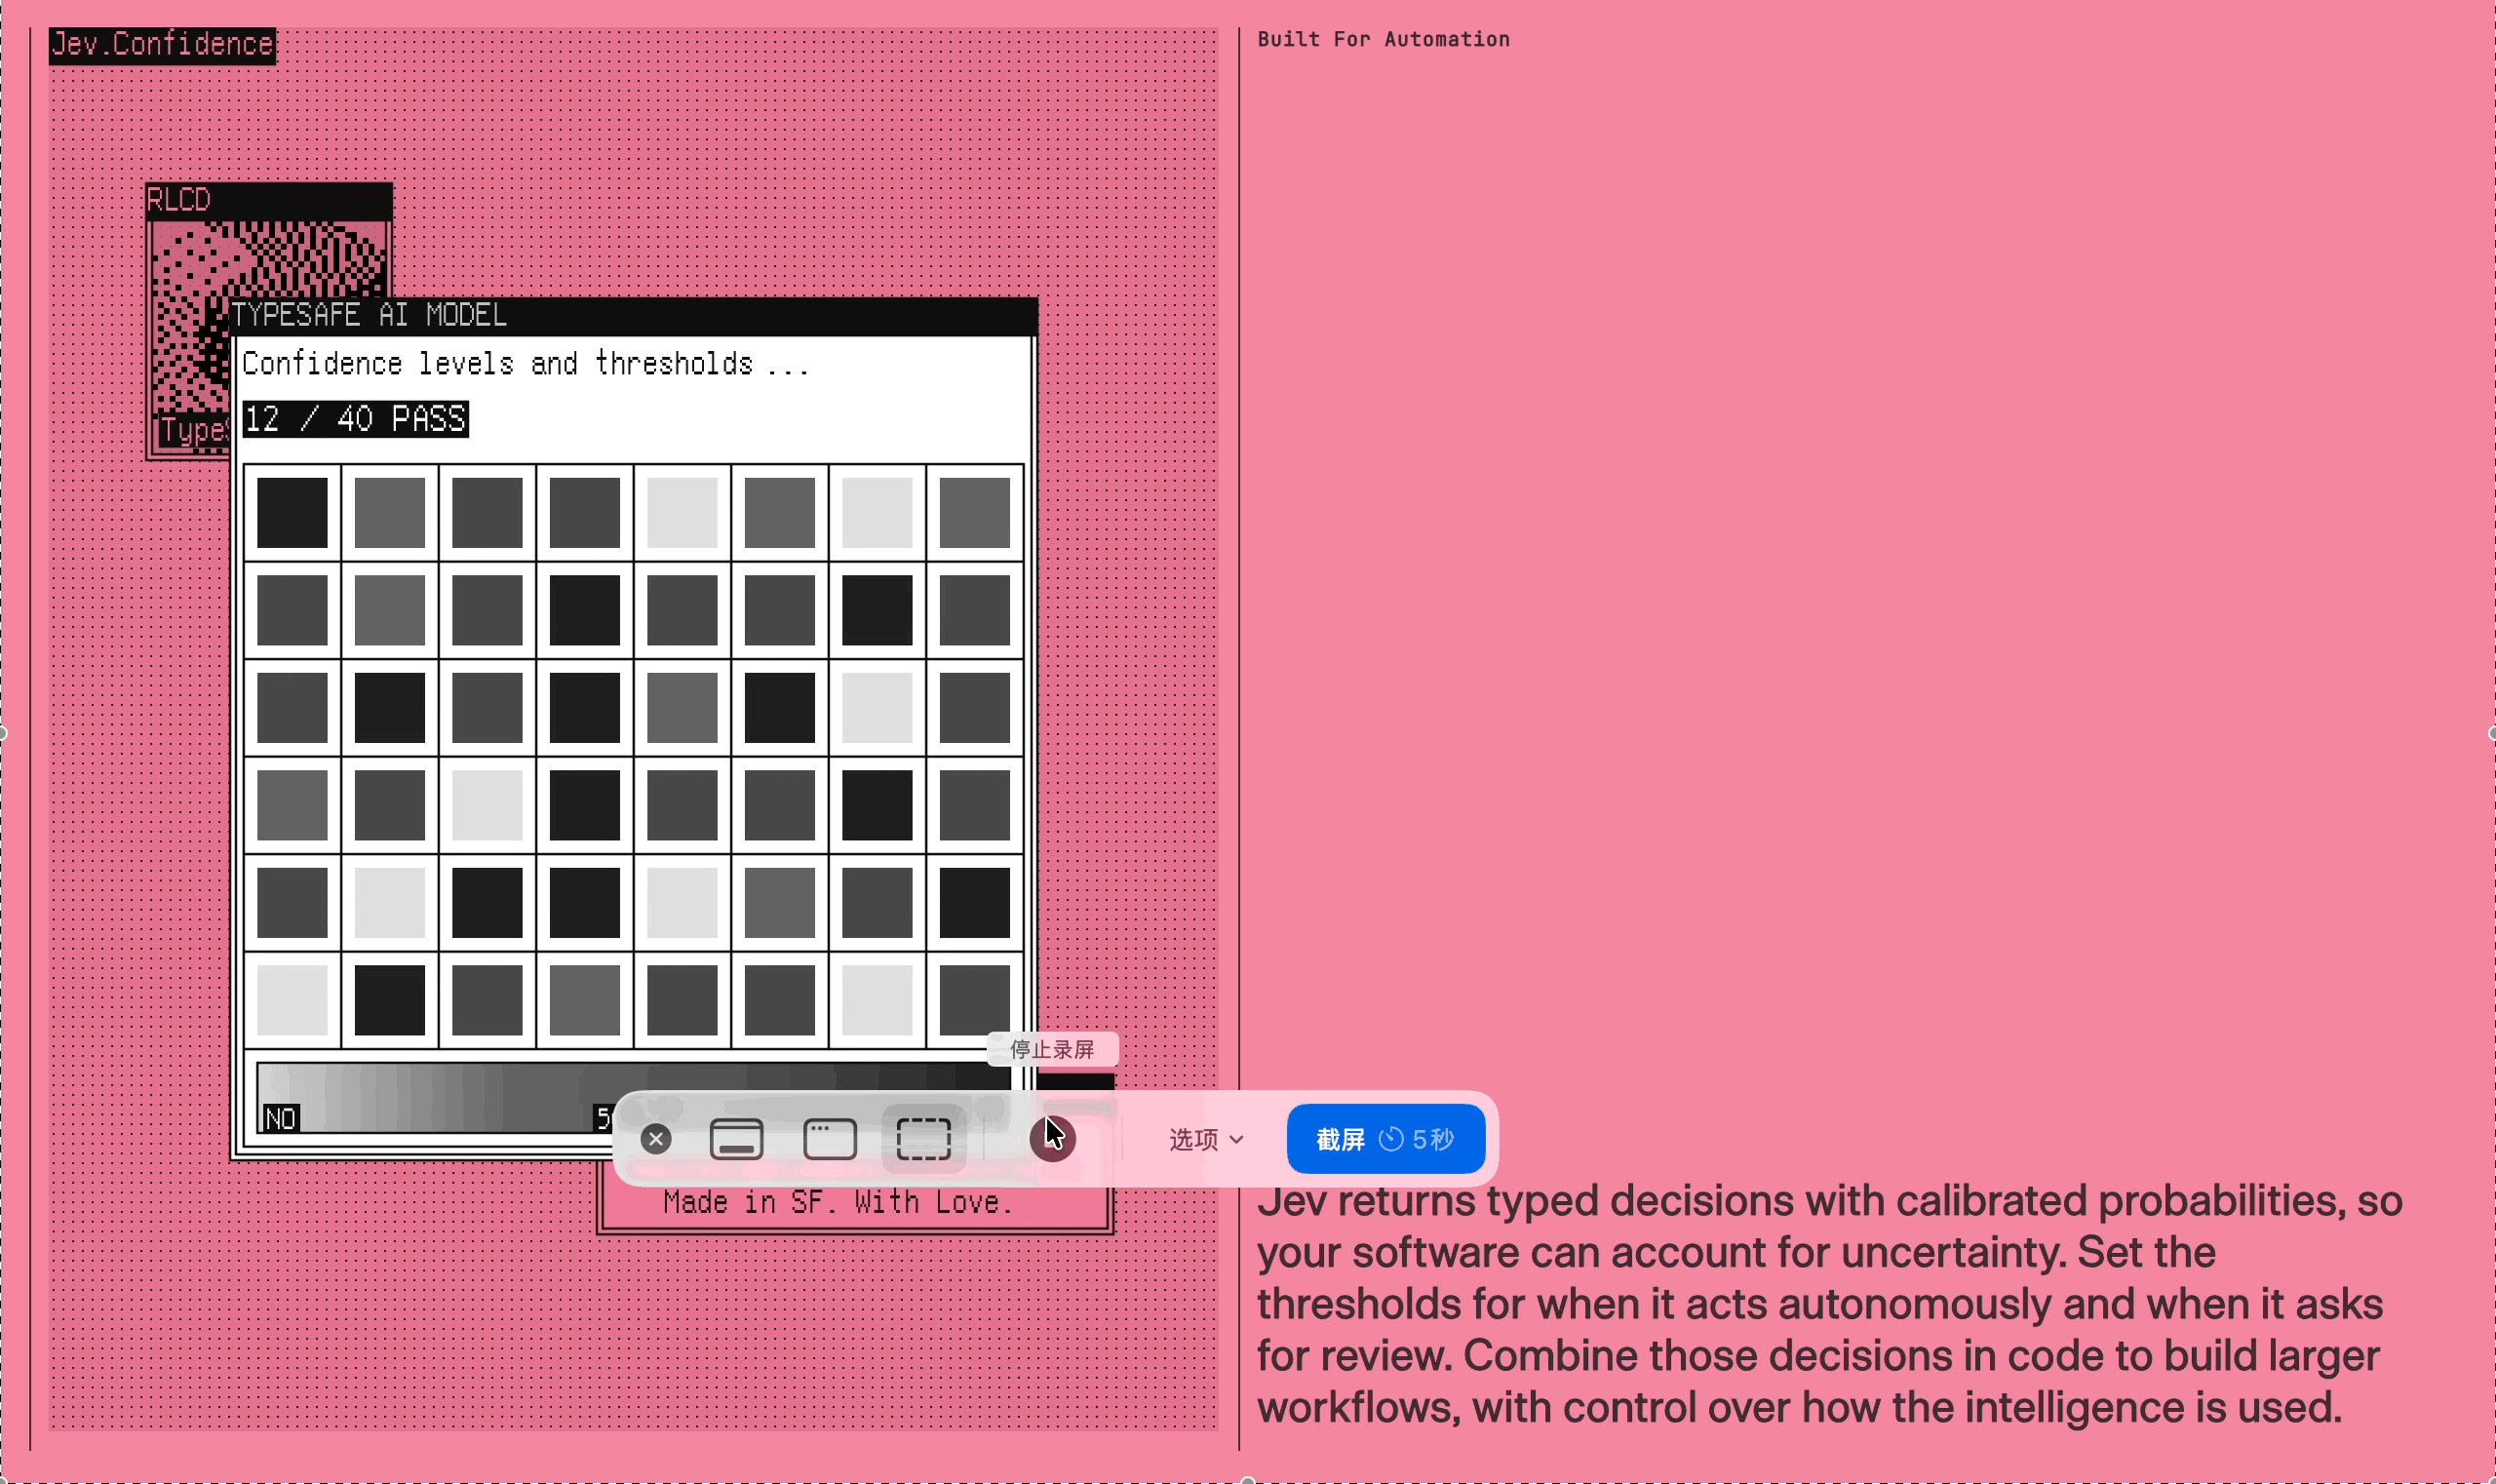
TypeSafe将Jev定位为"System One Model",取自卡尼曼《思考,快与慢》中的快速直觉判断系统。其核心创新在于RLCD——面向校准决策的强化学习。与优化人类偏好的RLHF不同,RLCD重点解决"模型置信度是否可靠"的问题。这对Agent系统进入生产环境尤为关键,因为只有校准良好的概率才能建立稳定的分流机制:高置信度任务自动执行,中等置信度交由更强模型复核,低置信度转人工处理。
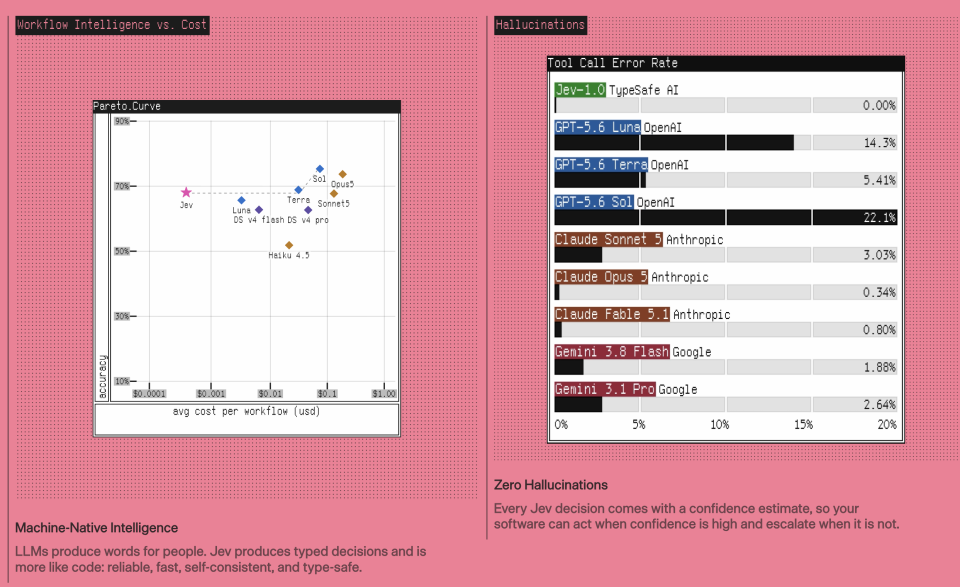
然而,这些性能数字需要谨慎解读。首先,测试任务本身是Jev最擅长的分类、选择、评分型任务,与通用生成模型比赛此类项目天然放大其优势。其次,评测由TypeSafe自己完成,公司承认测试任务由其model capabilities团队设计,部分参考答案来自强模型生成而非人工标注。所谓"193.6倍速度提升"是特定任务中的最大差距,并非普适结果。
更值得注意的是,Jev宣称的"Zero Hallucinations"实际指输出不会超出预定义类型,而非解决事实性错误。类型正确不等于判断正确,若模型返回"狗:97%"但实际是猫,业务结果依然错误。TypeSafe也未公开完整论文、参数规模和训练数据,外界无法判断RLCD究竟代表新范式还是已有方法的工程组合。
社区对此反应两极。支持者认为,如果成本和速度数据属实,Jev可能成为Agent系统中的高效路由器;质疑者则指出,现有Flash小模型配合JSON Schema和Structured Output已能返回结构化答案,传统分类器成本可能更低。一套真正有说服力的测试应该把Jev、Flash模型、传统分类器放在同一批真实任务中,统一比较准确度、置信度校准、延迟和成本。
无论Jev最终成败,它确实提出了一个值得思考的问题:AI的智能是否必须通过高消耗的语言生成来实现?当Agent系统需要数百次模型调用时,其中大量路由、分类、验证步骤或许确实不需要完整的生成式LLM。TypeSafe希望"智能判断"足够便宜后能被大规模嵌入软件,这与杰文斯悖论的逻辑一脉相承。
免责声明:本文基于公开报道的事实信息整理,仅供参考。AI新纪元聚焦人工智能前沿动态,内容来源于公开渠道,如有不实请联系我们删除。


发表评论 取消回复