导语:字节跳动Seed团队一天之内连发三篇论文,直接瞄准AI自我改进领域最核心的难题——如何从半闭环的递归自我改进走向真正的闭环RSI。三篇论文分别拆解了目标设定、经验整合和工作流自改三个维度,揭示了当前AI自我进化仍然面临的深层瓶颈。
2026年9月1日,ByteDance Seed与TokenWave发布了一个名为Self-Developing Agents的项目,三篇论文同步挂上arXiv。项目页直接将其定义为"From Half-Loop to Closed-Loop RSI"——从半闭环的递归自我改进,走向真正的闭环RSI。
在研究团队看来,今天很多所谓的RSI系统虽然已经形成了一个循环——模型执行任务、获得反馈、根据反馈修改自己、然后再次执行——但这个循环里依然有一个隐藏的人类"Golden Verifier"。人类提前告诉模型应该优化什么,提供评价标准,设计验证器,模型虽然在"自己改自己",但并没有真正决定自己应该往哪里进化。
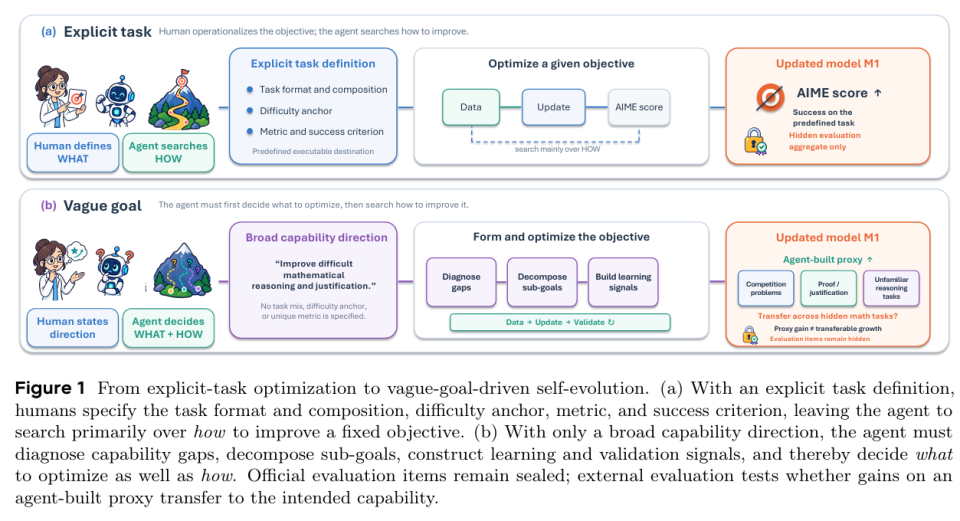
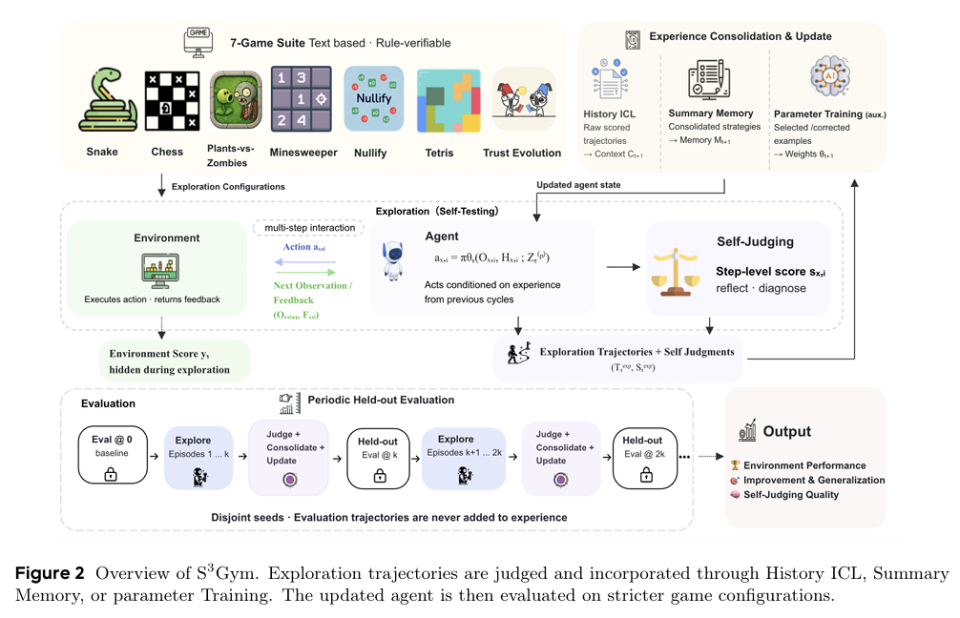
项目没有直接宣布RSI已经实现,而是把现在的Self-Improvement为什么还没有形成真正闭环拆成了三个具体问题:Aspire——AI能不能从模糊目标中决定自己该改什么?S³Gym——AI能不能从自己的经历中判断什么值得学习?HarnessDev——AI能不能进一步修改自己的Agent工作方式?
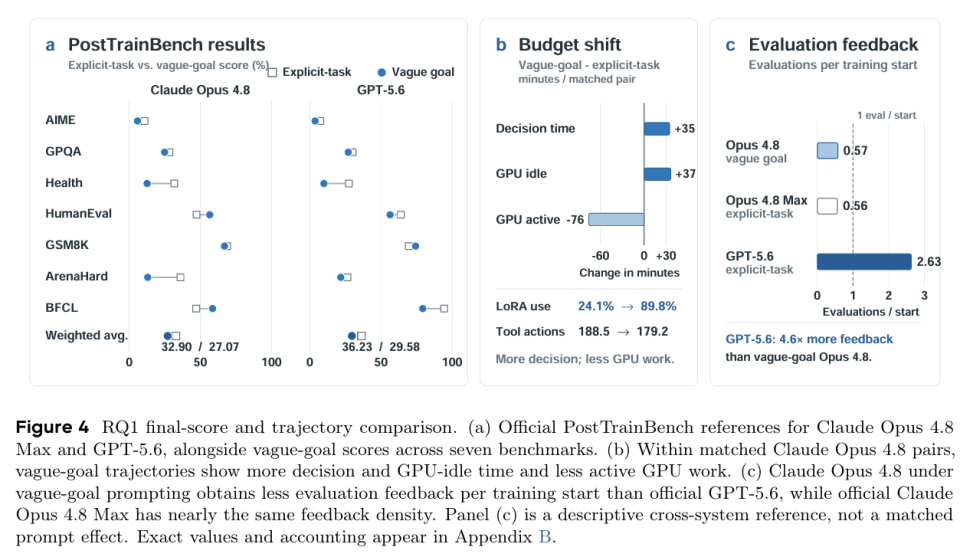
Aspire解决的核心问题是目标设定。传统的Self-Improvement通常从一个已经定义好的任务开始,研究人员告诉模型要提升什么能力、给出训练数据和验证集。但如果只告诉Agent一句"提升数学推理能力",事情马上就变了——它需要自己回答应该学习什么、需要什么数据、采用什么训练方法、怎样判断训练有没有效果。
Aspire一共进行了30个实验单元,其中28个产生了可以进一步评估的checkpoint。但真正能够在隐藏评测中留下有效提升的只有1个。模型并不是不会训练,恰恰相反,它可以非常顺利地完成数据生成、训练、Harness修改等一系列操作。真正困难的是它很难判断自己到底应该优化什么。
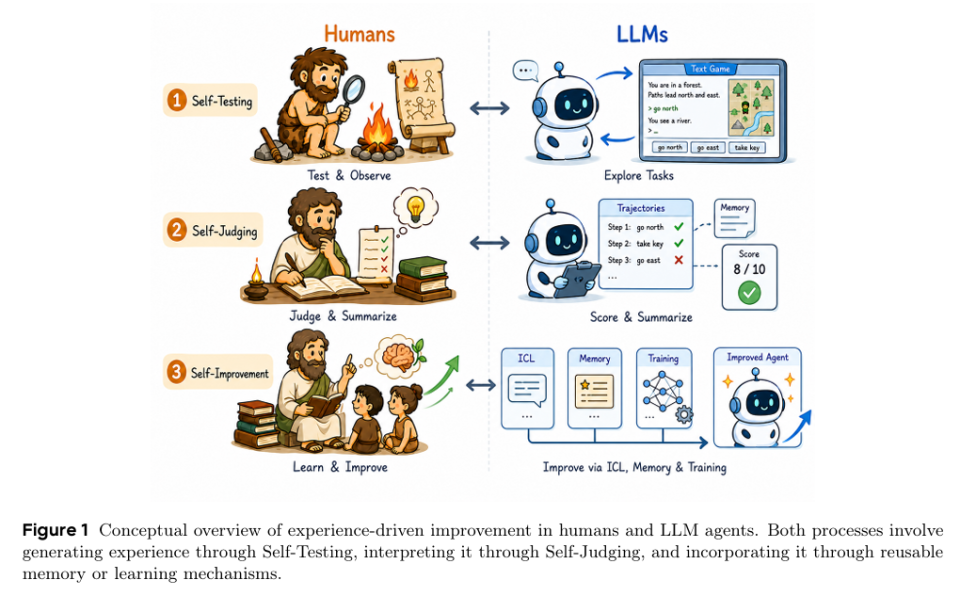
S³Gym进一步追问:过去发生的事情能不能真正改变未来的行为?研究团队设计了7个带有可执行Verifier的文字游戏环境,比较了History ICL、Summary Memory、Parameter Training三条经验利用路径。结果并没有出现一个能通吃所有环境的方案——有些环境更适合保留具体历史状态信息,另一些则更适合把经验压缩成策略规则。
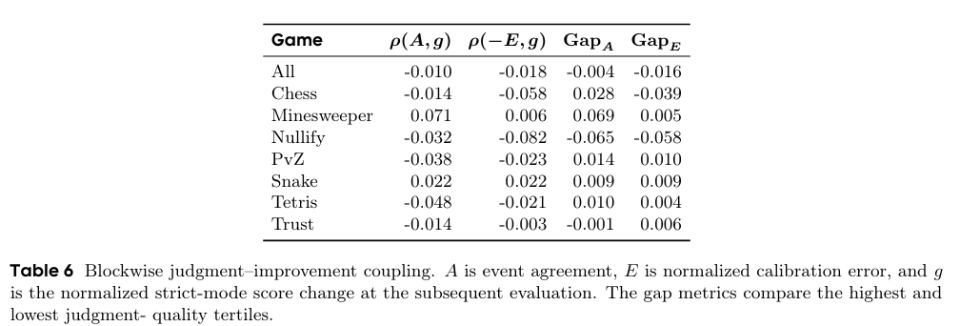
S³Gym最值得注意的结果是Agent的自我判断并不可靠。如果模型能够准确判断自己刚才的经验是否有价值,那么Self-Judging结果应该能预测下一轮性能变化。但实验显示两者几乎没有相关性,相关系数只有ρ = −0.010和−0.018。AI认为"这次经验很好",并不意味着下一次真的会做得更好。
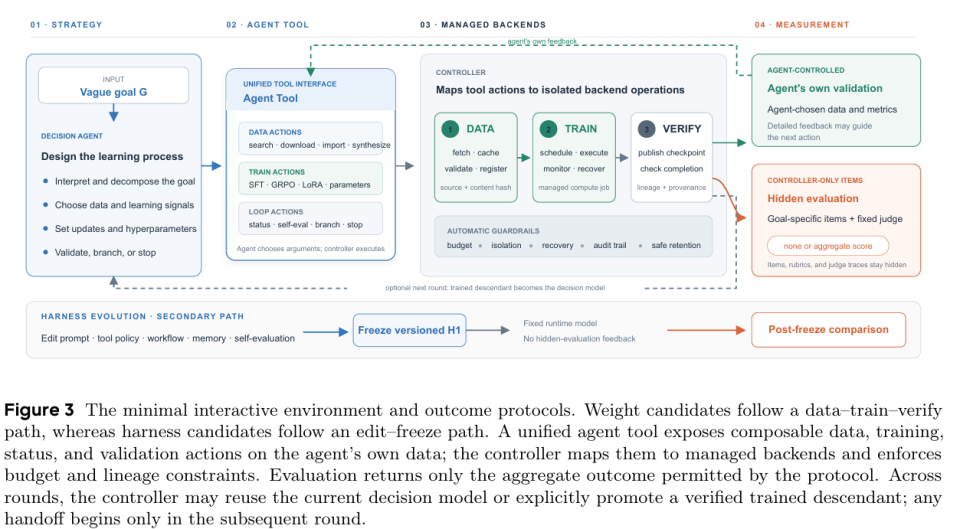
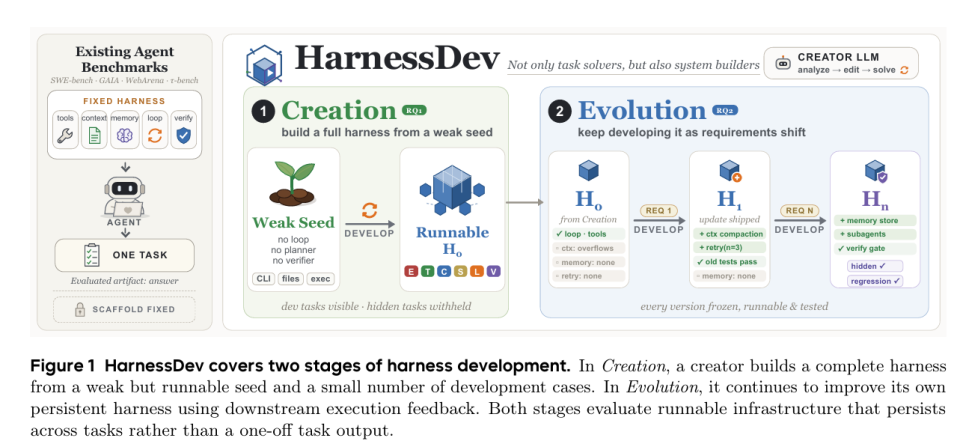
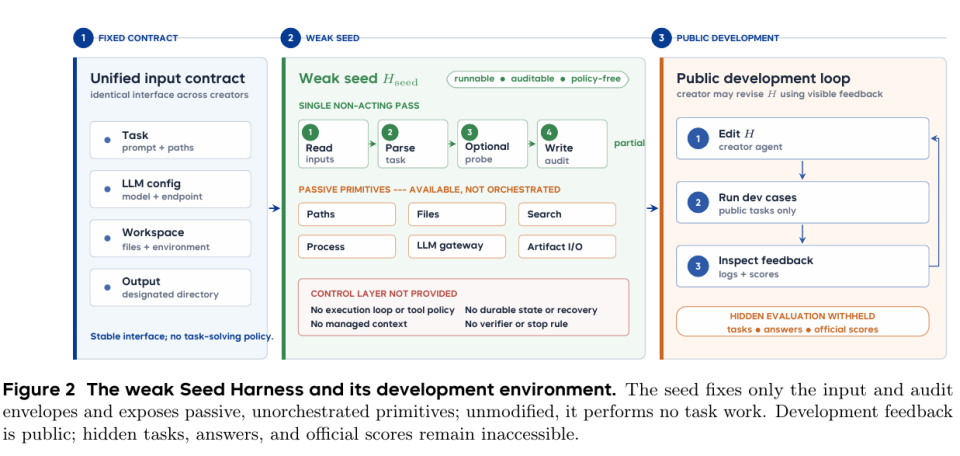
HarnessDev把自我进化的对象进一步扩大:不仅让模型改自己,还让Agent学会修改自己的工作方式。一个Agent真正执行任务时,影响结果的不只有模型参数——怎么拆任务、什么时候调用工具、如何管理Memory、如何保存状态、怎样组织执行流程,同样决定最终效果。
实验中模型一共生成了18个Code Harness,全部能够运行。但一些Harness在代码层面加入了State Management、Memory等机制,实际执行过程中却根本没有出现。代码中存在一个机制,不等于运行时真正拥有这个能力。在64次版本切换中,只有34次的可见任务变化方向与held-out任务一致,方向一致率仅53.1%。
最终9个被Agent自己认为最好的版本中,只有2个在held-out数据上真正达到最优。自我修改和自我改进是两件完全不同的事情——Agent可以非常积极地修改自己,但如果这些修改不能迁移到新的任务,它就只是"变化",还不能叫"进化"。
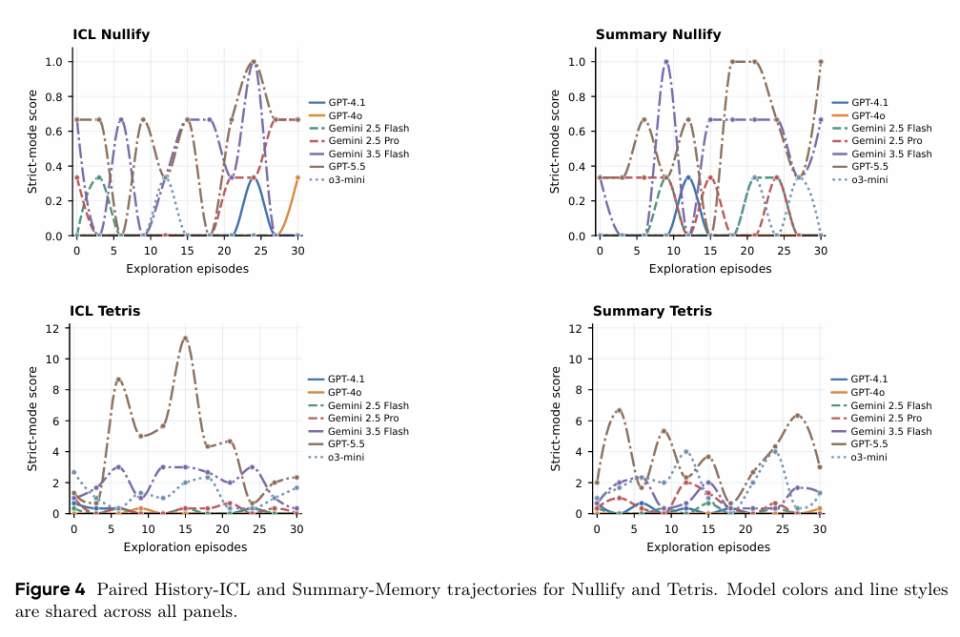
三篇论文给出的结果并不是AI已经学会自己进化,恰恰相反,大量实验都在说明这件事现在还非常不稳定。AI可以自己生成训练方案、自己总结经验、也可以自己修改Harness,但每一步都可能出现问题。最关键的是,局部变好并不等于整体变强。
项目页里最值得注意的一句话是:"The goal is not constant change. It is knowing which changes to keep."让AI知道什么值得改、什么真的有效、以及什么应该留下。如果说过去的Agent是在完成任务,那么Self-Developing Agent想做的事情显然更进一步:让Agent开始参与自己的成长过程。这条路现在还远没有走通。
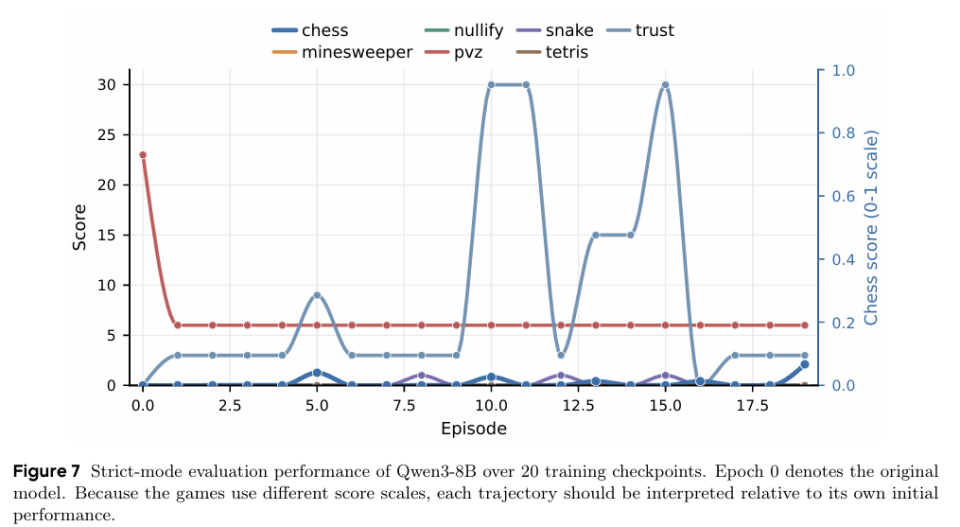
在Qwen3-8B的连续checkpoint实验中,模型在某些环境里的性能并没有随着训练持续上升。其中PvZ任务的表现甚至从23一路下降到6,之后长期停留在较低水平。参数训练虽然在部分任务上确实可以带来提升,但稳定性并不好,还可能出现明显的负迁移。
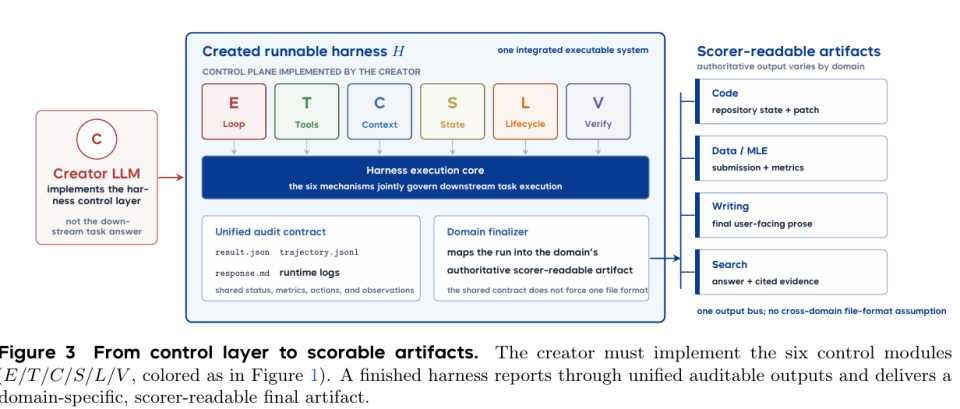
在后续的Harness Evolution中,模型修改最多的不是Memory和State Management,而是Execution Flow和Tools。这说明模型确实能够修改自己的系统,但它并不一定知道什么才是影响最终性能的关键。这也呼应了Aspire的发现——判断优化方向本身就是最大的难题。
这项研究的意义在于,它不是简单地说"AI还不能自我进化",而是精确地定位了三个具体缺口:目标形成、经验整合、机制迁移。每一篇论文都用大量实验量化了问题的严重程度,为后续研究提供了清晰的路线图。从半闭环到闭环,中间隔着的不仅是技术,更是AI对自身认知能力的根本突破。
免责声明:本文基于公开报道的事实信息整理,仅供参考。AI新纪元聚焦人工智能前沿动态,内容来源于公开渠道,如有不实请联系我们删除。


发表评论 取消回复