导语:谷歌在国庆假期凌晨发布了旗舰模型Gemini 4 Argon,多项基准测试能力超过GPT-6 Astra和Claude Opus 5.5。不过普通用户暂时还用不上,跑分横扫和真实手感之间还有距离——大厂卷得越凶,用模型的人越受益。
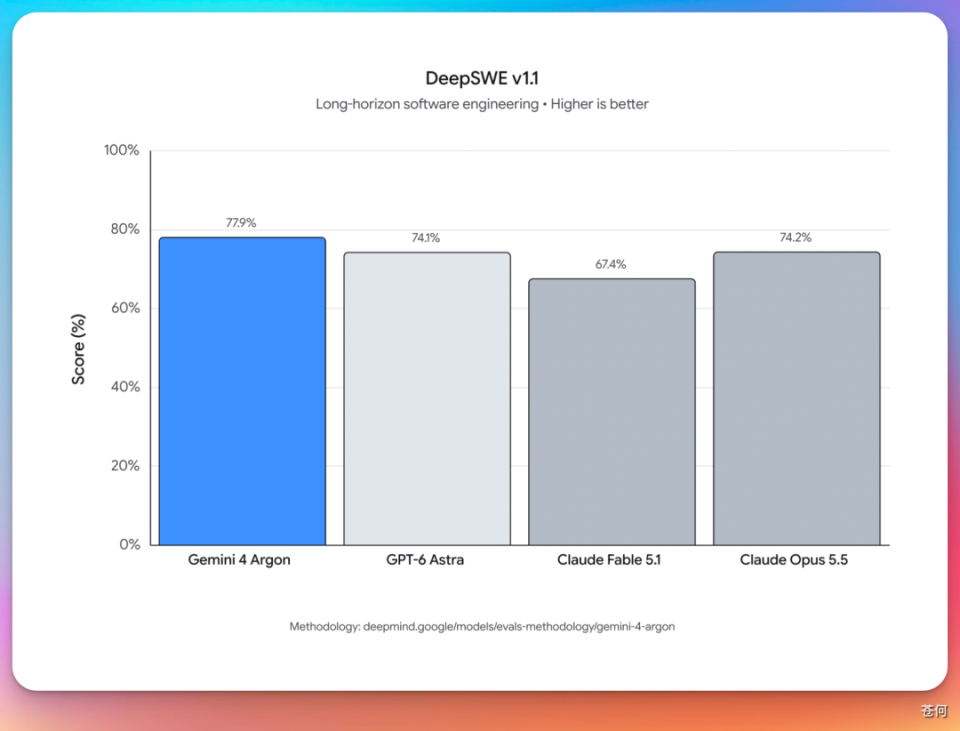
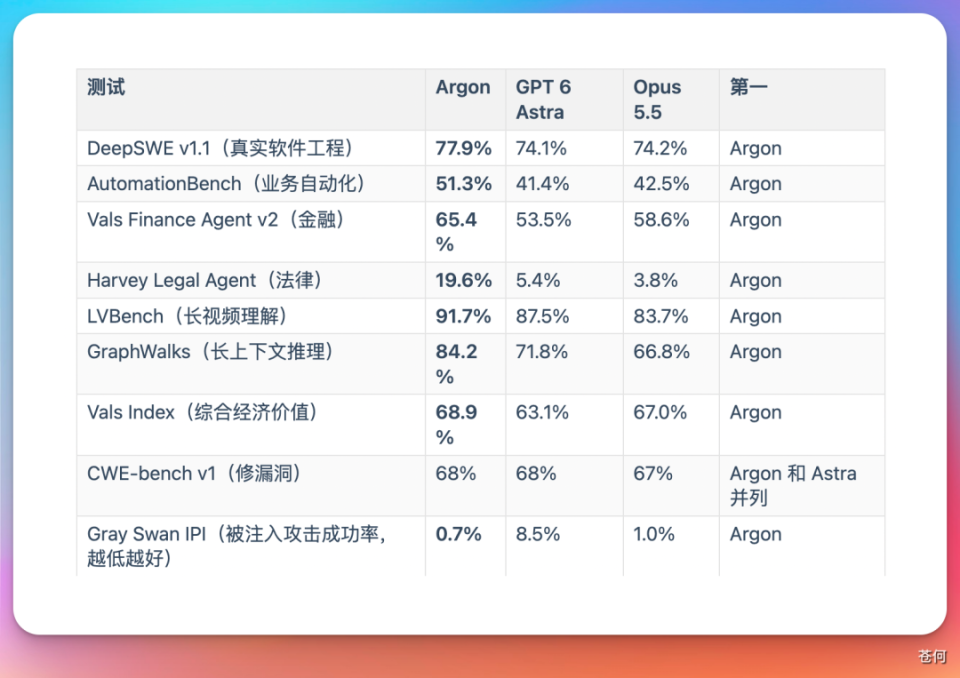
猜到它会来,但没猜到它又赶在这个点发布。就在昨夜凌晨,当我们还沉浸在梦乡的时候,谷歌发布了他们家新的旗舰模型Gemini 4 Argon。这个模型太猛了:多项基准测试能力都超过了GPT-6 Astra和Claude Opus 5.5。特别是在DeepSWE v1.1(真实软件工程任务)中以77.9%位列全球第一,Vals Index、AutomationBench也都拿了第一。谷歌一共公布了18项测试:Argon独占第一12项,并列第一1项;GPT-6 Astra赢3项,Opus 5.5赢2项。谷歌如今再次重回人工智能领域三大顶尖实验室之列。
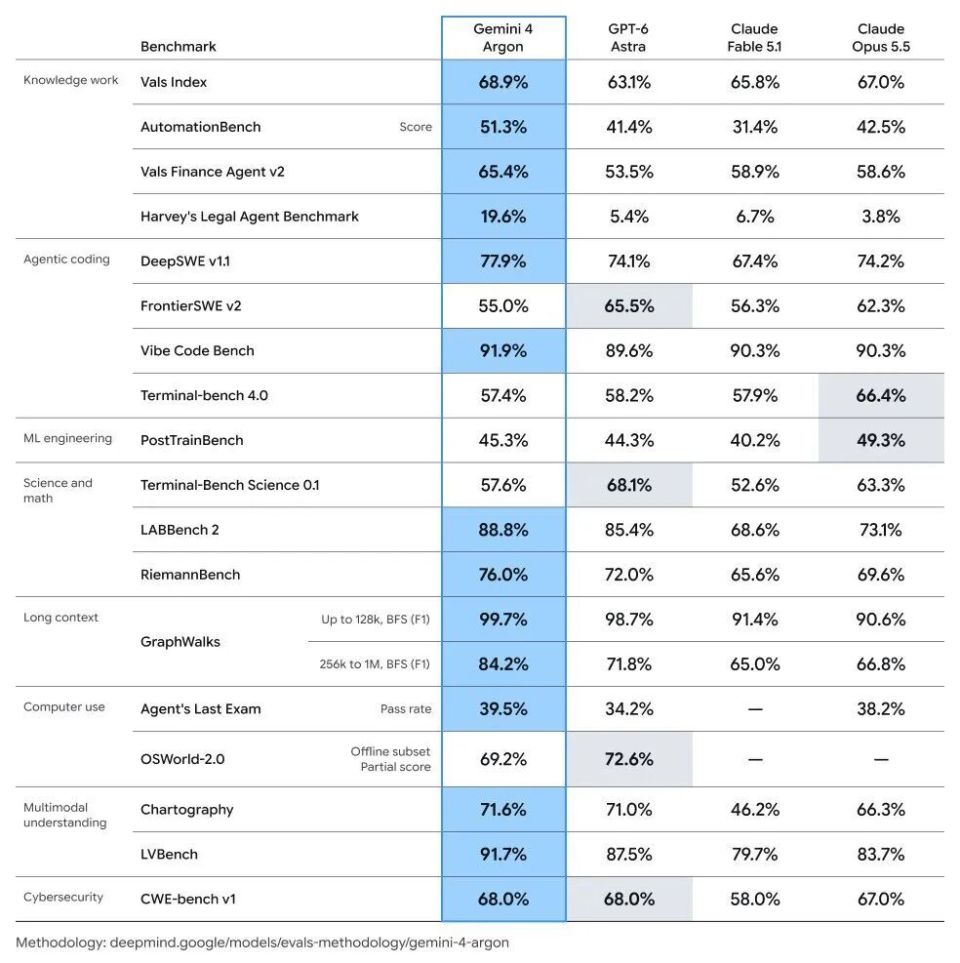
Gemini 4 Argon是Google DeepMind七个多月以来推出的首款高于Flash级别的自主研发模型。凭借其高推理能力(目前最高级别),它在人工智能分析智能指数(AII)中获得53分,与GPT-6 Astra持平,比GPT-6.1 Sol高出1分——其得分提升主要得益于更少的幻觉和更强的自主能力。在AA-Omniscience测试中,Gemini 4 Argon的幻觉率仅为15%,是所有智能指数得分45分以上的模型中最低的。输出上限更是直接拉到100万token(之前是64K),业界第一;支持文本、图像、视频和语音输入,并输出文本。
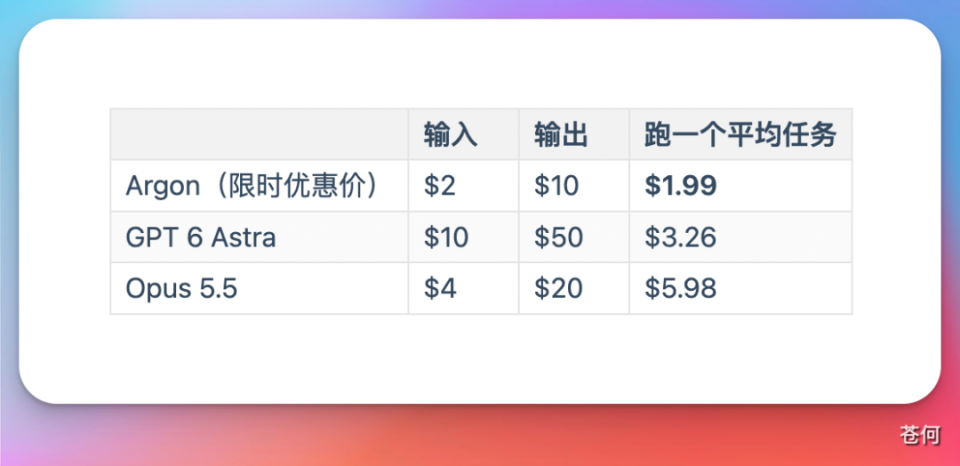
API价格方面,标准价格为每百万输入/输出令牌4美元/20美元,目前优惠50%,价格为2美元/10美元;缓存输入令牌可享受95%的折扣(折扣价为每百万0.10美元),高于Gemini 3.8 Flash的90%折扣。智能体性能历来是Gemini模型的弱项,但Gemini 4 Argon在各项智能体评估中均有所提升:它在AutomationBench-AA测试中以77.5%的成绩位列第一,比Claude Sonnet 5.5高出6分。Gemini 4 Argon主打长程复杂任务——软件工程、金融/法律知识工作、网络安全防御。数千名谷歌员工强调了该模型在专业编码任务、深度研究和高质量写作方面的优势。
谷歌还放出了一篇博客文章,放了一些他们的case:他们利用Argon帮助量子计算研究人员优化那些限制重要应用性能的子程序的时空资源(量子比特×量子门)。例如,在短短几分钟内,它就将性能提升了40%,超过了已发布的基准水平。他们还拿Argon做内部的内存优化——Argon Agent Team分析了整个集群的分析遥测数据,自主识别并应用了Google数据中心的内存优化,一旦推出,即可释放超过300 TiB的内存,预计总共可节省500 TiB到1 PiB的内存。在大规模代码库迁移与优化工作中,Argon团队正在将Google各部门的C/C++代码库迁移到Rust,迁移规模从re2、libgav1等核心库的数万行代码,到Fuchsia Zircon内核的80万多行代码不等——如此大规模的代码迁移,对模型能力的考验不是一点半点。
不过可惜的是,现在大部分人还无法使用:先开放给可信网络安全防御者,之后轮到付费API和AI Ultra用户。没拿到测试,在当下,我认为Claude Opus 5.5依旧是神,那种爽感是完全不一样的——如果Gemini 4 Argon比不过Opus 5.5,大概率就是在拉。还有,我不知道为什么每次这帮人老喜欢在中国的节假日发布新模型,太气人了。国庆第一天,别人在高速上堵车,我在电脑前熬夜看跑分,麻了。模型不放假,我们也别想放假,苦了。
吐槽归吐槽,谷歌这次确实拿出了真东西:100万token输出、80万行代码迁移、300 TiB内存优化,都是谷歌在自家业务里实打实跑出来的。但讲真的,跑分这东西,看看就好。官方数据里Argon横扫一片,到了第三方评测,也就和GPT-6 Astra打个平手。发布会看跑分,干活还得看手感。等Argon正式开放,我第一时间拉真实项目去测,到时候再给大家出一期实测。大厂卷得越凶,我们这些用模型的人就越爽。
免责声明:本文内容整理自公开报道,AI 产品动态与进展以官方发布为准,仅供参考,不构成任何投资建议。



发表评论 取消回复